Jakub Jankiewicz schreef dat alle AI-gegenereerde code open source zou moeten zijn. Afgelopen weekend stond zijn stuk op de voorpagina van Hacker News, met 612 reacties.
De draad valt uiteen in twee kampen. Het ene zegt: de AI deed het werk, dus het is niet van jou. Het andere zegt: ik heb maanden ontwerpbeslissingen genomen, getest en bijgestuurd, dus het is wel van mij.
Beide kampen hebben het over moeite. Het recht vraagt daar niet naar. Het recht vraagt wie de vorm bepaalde.
De klacht is echt
Jankiewicz heeft twee argumenten. Het eerste is dat modellen getraind zijn op decennia aan open source code, die zonder toestemming of naamsvermelding is binnengehaald. Gesloten code bouwen op die output noemt hij license laundering.
De sterkste steun daarvoor staat in de draad zelf. Een maintainer van meerdere AGPL-projecten beschrijft hoe een bedrijf zijn code eerst zonder zijn naam, licentie of broncode uitbracht. Hij stuurde meldingen, en na maanden touwtrekken liet dat bedrijf een LLM het systeem namaken. Zijn oordeel over de kloon: "It's as if you asked an LLM to rewrite Harry Potter, with the same plot, but bad dialogue."
Dat is concrete schade, en een van de juridische routes daartegen ging in september in de VS dicht. In Doe v. GitHub oordeelde het Ninth Circuit op 16 september, afgaand op de klacht zelf, dat Copilot en Codex nieuwe code genereren en dus geen kopie maken waaruit de copyrightvermelding is verwijderd. De DMCA-claim strandde. Of de output inbreuk maakt, liet het hof open.
Het tweede argument is al geldend recht
Het tweede argument van Jankiewicz is juridisch: code die geen mens schreef, krijgt geen auteursrecht. Daar heeft hij gewoon gelijk in, en sinds dit voorjaar staat het steviger dan ooit.
- Verenigde Staten. Het Supreme Court weigerde op 2 maart Thaler v. Perlmutter te behandelen. Daarmee blijft de uitspraak van de lagere rechter staan: zonder menselijke maker geen auteursrecht. Het rapport van het Copyright Office uit januari 2025 maakt het concreet, met als voorbehoud dat het om de techniek van nu gaat: "prompts do not alone provide sufficient control."
- Verenigd Koninkrijk. Daar beschermt sectie 9(3) van de copyrightwet nog werken die een computer zelfstandig maakte. De regering stelde in maart voor die bescherming te schrappen. Een wetsvoorstel is er nog niet.
- Europa. Hier ligt de lat al sinds Infopaq in 2009 bij een "eigen intellectuele schepping" van de maker. Een model is geen maker.
Puur gegenereerde code is dus in de praktijk al van niemand. Jankiewicz vraagt om iets dat grotendeels al zo is, alleen zonder LICENSE-bestand.
Waar het voorstel breekt
Een licentie veronderstelt eigendom. Een andere reageerder zegt het in één zin: "If AI code is not copyrightable, then no license can govern it."
Een MIT- of CC0-licentie op code waar niemand rechten op heeft, is een etiket. Het verandert niets aan wat een ander ermee mag.
En de AGPL-maintainer schiet er ook niets mee op. Komt die kloon morgen onder een MIT-licentie uit, dan staat zijn naam er nog steeds niet op. Zijn probleem zit aan de kant van de training en de naamsvermelding, en daar gaat een licentieplicht op de output niet over.
Een derde reageerder vroeg zich af of zijn eigen code dan ook open source moet, aangezien hij zelf ook op een enorme berg open source code getraind is. Daar heb ik geen antwoord op, behalve dat mijn trainingsdata in 1984 begon en duidelijk minder goed gefilterd was.
Eigendom begint waar je ingrijpt
Interessant wordt het bij de vraag waar het Copyright Office de grens trekt. Menselijke bijdragen die je in de output terugziet, zijn beschermd, en dat geldt ook voor de creatieve selectie, coördinatie of ordening van gegenereerd materiaal. Het rapport citeert een uitspraak uit 1989 die nu ineens heel actueel klinkt: "The supplier of an idea is no more an 'author' of a program than is the supplier of the disk on which the program is stored."
Op je eigen werkdag ziet dat er zo uit:
| Wat je deed | Van wie |
|---|---|
| Prompt geschreven, output geaccepteerd | niemand |
| Output gelezen en goedgekeurd | niemand, goedkeuren is geen schrijven |
| Code herschreven, opgesplitst, anders opgezet | jij, voor dat deel |
| Bepaald welke stukken waar komen en hoe ze samenhangen | jij, voor die ordening |
Dat is grofweg dezelfde grens als die tussen code die je begrijpt en code die je hebt laten passeren. Wat je niet snapt, ga je ook niet herschrijven. Het argument om nooit code te shippen die je niet aan een collega kunt uitleggen blijkt dus ook een eigendomsargument. Juridisch is het deel waar je over kunt praten ongeveer het deel dat van jou is.
Bewijs maar eens wat van jou is
Dan de praktische kant. Stel dat het er ooit toe doet: kun jij aanwijzen welke regels van jouw hand zijn?
Ik niet. Toen ik 1.644 commits in tien van mijn publieke repositories naliep, had geen enkele commit een agent-trailer, omdat ik die zelf had uitgezet. Het auteursveld bleek gevuld door wie er op de mergeknop drukte. Nergens in die historie staat welke regels van mij kwamen, dus ik kan niet aantonen dat ik mijn eigen code geschreven heb. Dat is een ongemakkelijke zin om te publiceren op een blog die vooral over vakmanschap gaat.
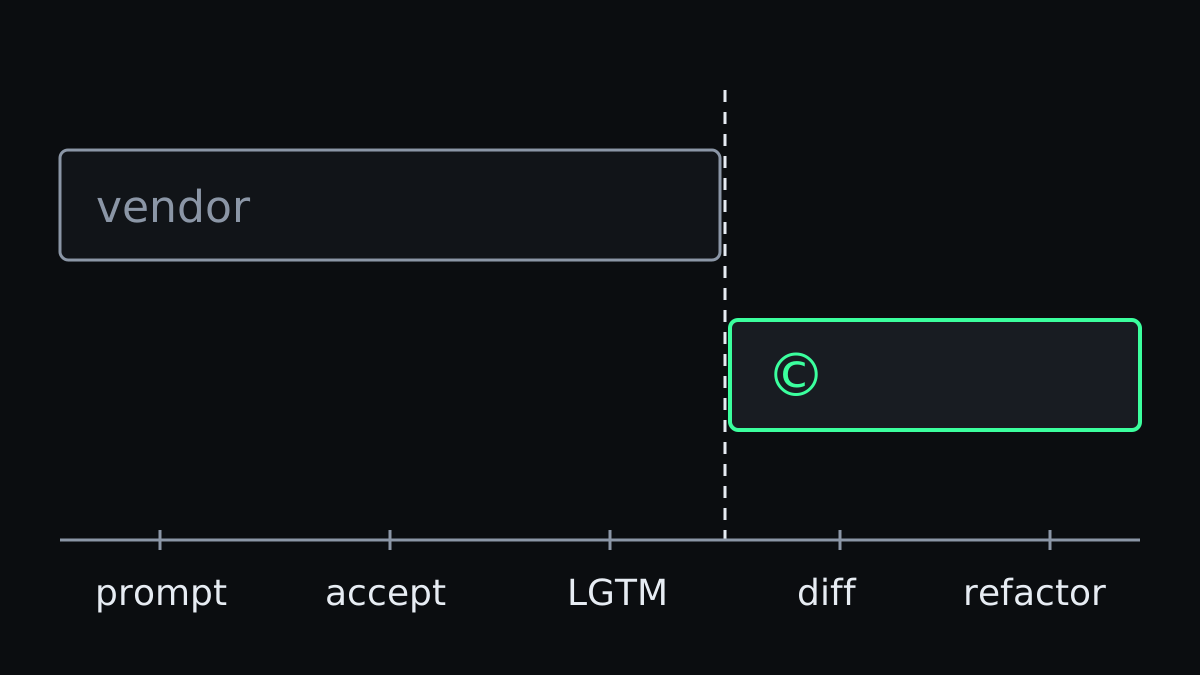
De vendor helpt je daar niet bij. De commerciële voorwaarden van Anthropic dragen de rechten van het bedrijf op de output aan je over, letterlijk "its right, title and interest (if any)". Het draait om die twee woorden tussen haakjes. Als er geen rechten zijn, valt er niets over te dragen.
En de vrijwaring voor IE-claims in diezelfde voorwaarden geldt niet voor "modifications made by Customer to the Services or Outputs". Precies het deel dat van jou wordt, dekt de vendor dus niet meer. Dat patroon zag ik eerder bij Copilot, toen ik schreef over wie er verantwoordelijk is als AI-code misgaat.
Wat ik zou doen
Ik ben geen jurist, en dit is geen juridisch advies. Wel wat ik in mijn eigen werk anders aanpak:
- Claim geen auteursrecht dat je niet kunt onderbouwen. Een copyrightregel bovenaan een bestand dat een agent in één keer schreef, is een bewering zonder fundament.
- Houd bij waar je ingreep, voor de code die ertoe doet. De kern van je product, het algoritme waar je klant voor betaalt. Een commit waarin jij de gegenereerde versie herschrijft, met een bericht dat zegt waarom, is bewijs. Een squash-merge van veertig agent-commits veegt het uit.
- Lees je opdrachtovereenkomst. Draag je daarin de intellectuele-eigendomsrechten over aan je klant, of garandeer je dat het werk origineel is? Dan beloof je bij gegenereerde code mogelijk iets dat niet bestaat.
- Zoek in de voorwaarden van je vendor naar "if any" en naar de uitsluitingen. Vijf minuten werk, en daarna weet je wat je wel en niet hebt.
Jankiewicz vraagt wie AI-code mag gebruiken. Dat blijkt voor een groot deel al beantwoord: iedereen, als niemand er iets aan veranderd heeft. De vraag die overblijft is wie hem kan uitleggen. Want van wie de code ook is, de bugs zijn van jou.