Maandag haalde ik de AI-tells van deze site weg. De regel die ik eraan overhield was simpel: een tell is een keuze die niemand maakte. Aan het uiterlijk zelf mankeerde niets. Wat weg moest, was alles waarvoor niemand een reden kon geven.
Eén vraag bleef hangen. Een ontwerp wordt gescreenshot en rondgestuurd, code meestal niet. Als een agent bij een ontwerp alles wat open blijft invult met het gemiddelde, wat doet hij dan met code, waar niemand meekijkt?
Dus heb ik het gemeten.
Hoe ik het gemeten heb
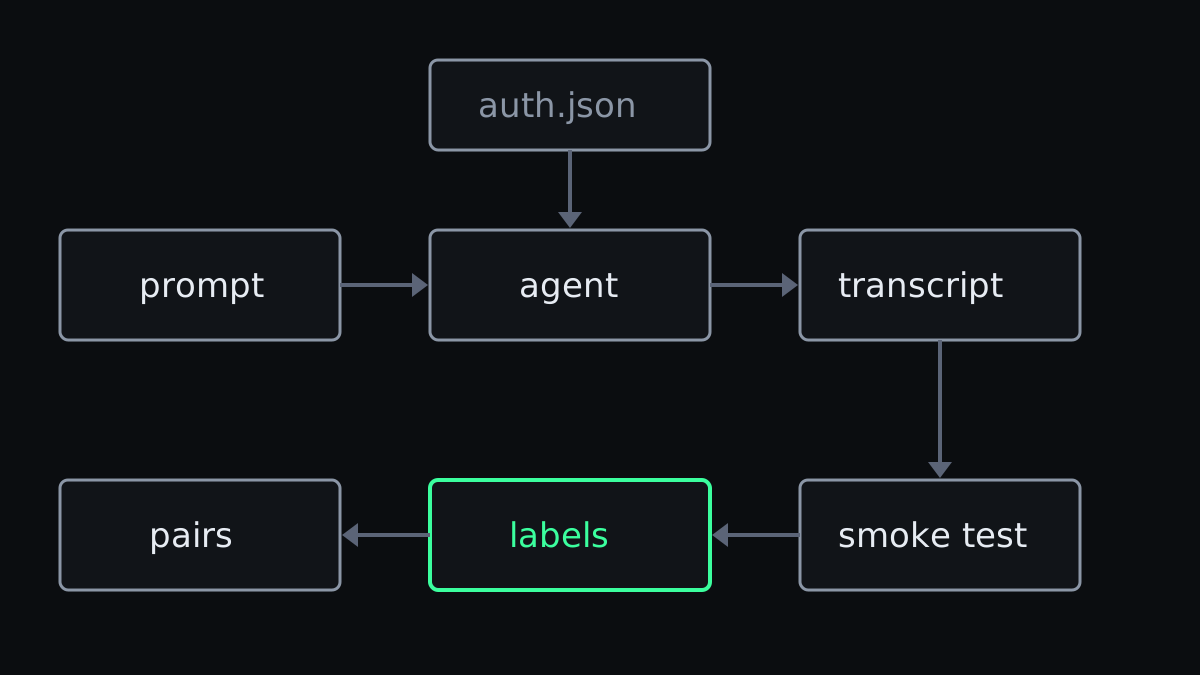
Het idee was eenvoudig: geef elk model dezelfde open opdracht en tel wat het zelf invult. Het meeste werk zat erin die vergelijking eerlijk te houden.
Drie opdrachten die bewust veel openlaten
Drie kleine TypeScript-opdrachten van een paar zinnen: een REST API voor bookmarks, een command-line tool die CSV naar JSON omzet, en een client library voor een onbetrouwbare HTTP API met een rate limit. Elke prompt noemt TypeScript en eindigt met "Include tests." De rest laat ik open: framework, opslag, test runner, argument parser, retry-strategie. Dit is de volledige API-prompt:
Build a small REST API in TypeScript for storing bookmarks. A bookmark has a URL, a title
and optional tags. Support creating, listing, fetching one, updating and deleting
bookmarks, and persist them so they survive a restart. Include tests.De taal heb ik vastgelegd, want bij de taalkeuze hebben modellen al een bekende voorkeur. Toen ik die in een eerste test openliet, schreef Gemini Python.
Elke agent met zijn standaardinstellingen, in een schone omgeving
Vijf harnesses: Claude Code, Codex, Antigravity, OpenCode en Freebuff. In totaal 23 modellen, elk met de standaardinstellingen van zijn harness. Antigravity zet het redeneerniveau in de modelnaam, dus daar moest ik kiezen: medium, en low voor het Pro-model, dat geen medium heeft.
Elke run kreeg een nieuwe, lege map en een nieuw proces, en verder niets. Agents lezen normaal gesproken veel uit je home directory: config, regels, geheugen, plugins, MCP-servers. Daarom draaide elk harness vanuit een schone home directory met alleen zijn login. Zonder die schone home laadde Antigravity mijn eigen MCP-servers en Claude Code mijn connectors voor Gmail en mijn agenda, en had ik mijn eigen setup gemeten in plaats van het model.
Vier van de harnesses draaien headless en rapporteren in JSON. Freebuff heeft alleen een terminal-interface, dus daar typt een kleine driver de prompt in tmux, leest het scherm en wacht tot de agent klaar is. Stelde een agent eerst een vraag, dan kreeg hij elke keer hetzelfde antwoord: "Choose whatever you think is best and build it." Elke run had maximaal 45 minuten.
Een collega (bedankt Jelle!) draaide GPT-6 Astra en GPT-6.1 Sol op een eigen account, met dezelfde meetopstelling en dezelfde prompts, en stuurde de resultaten terug.
Welk model gaf er echt antwoord
De naam in een modelkiezer is een bewering. Per run las ik uit het transcript, het sessiebestand of de database van de agent zelf af welk model er echt antwoordde, en ik markeerde elke run waar die twee niet overeenkwamen. Verderop zie je waarom dat nodig was.
Werkt het, en wat koos hij
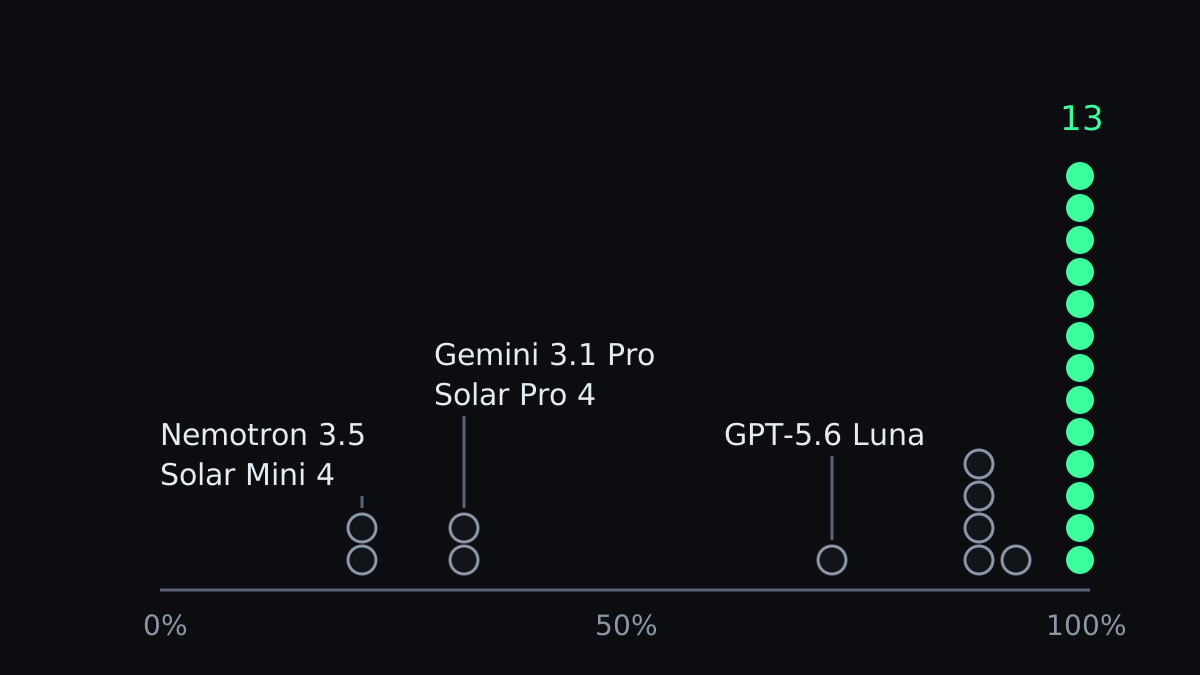
Daarna ging elk project door een smoke test, zoals een mens het zou proberen: installeren met de package manager die het koos, builden als het startscript een build nodig heeft, starten en de API aanroepen, een CSV met en zonder header omzetten, de eigen tests van de library draaien en type-checken met de eigen TypeScript-versie van het project. Faalde een project, dan las ik waarom. Een paar keer zat de fout in mijn eigen test. Dan repareerde ik de test en draaide ik hem opnieuw voor alle projecten.
De keuzes zelf lees ik af uit de broncode, nooit uit de tests of de README: welk framework er geïmporteerd wordt, waar de data heen gaat, welke test runner er geïnstalleerd is, hoe de wachttijd tussen retries oploopt. Elk daarvan is een as met een label per run. Labelde een regel een echte run verkeerd, dan werd die run eerst een test case, daarna werd de regel gerepareerd en kreeg elke run opnieuw een label.
Dan de vergelijking. Per as nam ik alle paren van runs en telde hoe vaak die twee hetzelfde kozen: paren van hetzelfde model, en paren van twee verschillende modellen. Doet een model gewoon wat in het vak gangbaar is, dan komen beide getallen gelijk uit. Heeft een model een eigen gewoonte, dan zijn de runs van dat model het vaker met elkaar eens.
Alle 23 modellen
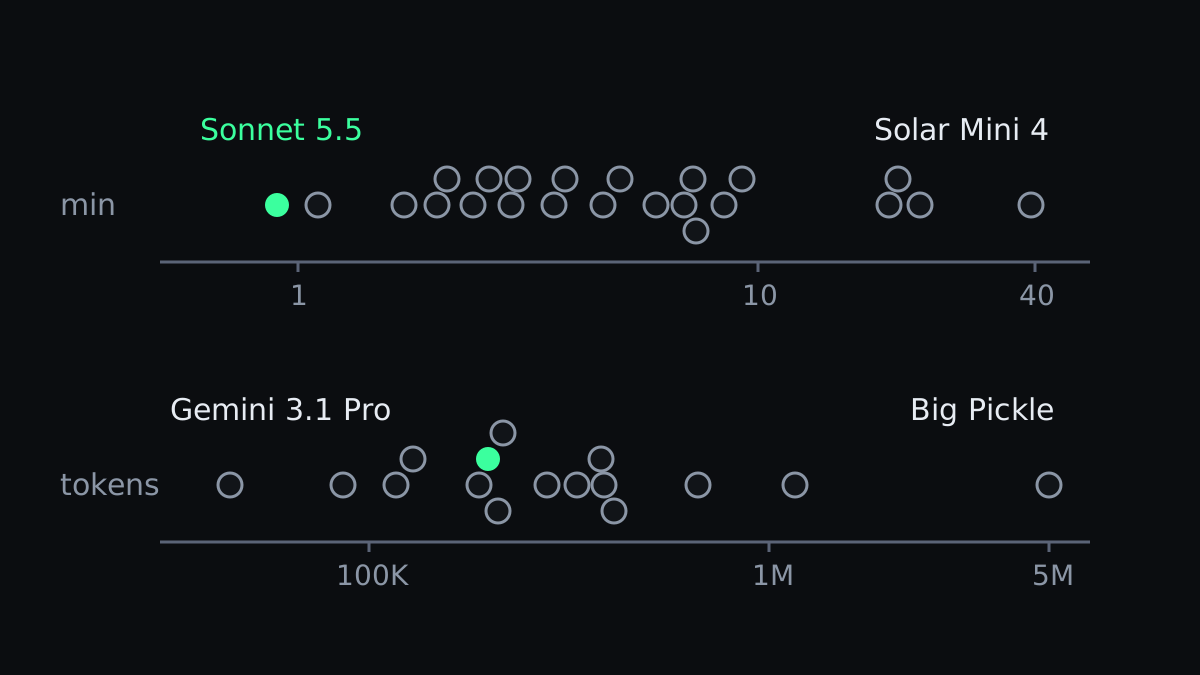
Per harness, elk model met de runs die werkten en de mediane duur per run:
- Claude Code: Haiku 4.5 (14/15, 2,9 min), Sonnet 5.5 (15/15, 0,9 min), Opus 5.5 (9/9, 2,1 min)
- Codex: GPT-5.6 Luna (11/15, 2,4 min), GPT-5.6 Terra (15/15, 1,7 min), GPT-5.6 Sol (8/9, 6,9 min), GPT-6 Astra (9/9, 3,8 min), GPT-6.1 Sol (9/9, 4,6 min)
- Antigravity: Gemini 3.8 Flash (15/15, 3,6 min), Gemini 3.7 Flash (15/15, 2,0 min), Gemini 3.6 Flash (9/9, 7,2 min), Gemini 3.1 Pro (3/9, 1,1 min)
- OpenCode: Big Pickle (9/9, 20,1 min), Muse Spark 1.3 (8/9, 2,6 min), Nemotron 3 Ultra (8/9, 9,2 min), Nemotron 3.5 Lightning (2/9, 22,4 min)
- Freebuff: GLM 5.3 Flash (9/9, 19,2 min), Solar Mini 4 (2/9, 39,1 min), MiMo 2.6 Flash (9/9, 8,4 min), Solar Pro 4 (3/9, 6,0 min), DeepSeek V4.1 Flash (15/15, 5,0 min), GPT-6 Luna (8/9, 3,0 min), MiMo 2.6 Pro (8/8, 7,3 min)
Een run werkte als hij de smoke test haalde. De grafiek hierboven zet de duur naast de tokens voor de vier harnesses die ze rapporteren: input plus output voor een hele run, grotendeels context uit de cache die het harness bij elke stap opnieuw inleest. Freebuff toont alleen hoe groot de context is.
Elk harness draaide op zijn eigen standaardredeneerniveau. In Freebuff is dat max voor GLM, high voor DeepSeek en GPT-6 Luna, en geen voor de Solar- en MiMo-modellen. Alleen bij Antigravity koos ik het zelf, zoals hierboven beschreven.
De runs liepen van 28 september tot en met 1 oktober 2026, op Claude Code 2.1.285, Codex 0.154.0, Antigravity 1.2.13, OpenCode 1.18.29 en Freebuff 0.1.4. Zeven modellen kregen vijf runs per opdracht, de rest drie. MiMo 2.6 Pro heeft één library-run minder: het betaalde uur was op voordat de laatste run kon beginnen.
Vier modellen staan niet in dit overzicht. Ling 3.0 Flash en de gratis mimo-v2.5 in OpenCode gaven in alle negen runs alleen fouten. Space Bunny Alpha in Freebuff faalde twaalf van de twaalf keer. En achter Muse Spark 1.2 bleek op het gratis plan van Freebuff een ander model te zitten, dus daar viel niets eigens aan te meten.
Duur was het hele experiment niet: ongeveer $13 tegen API-prijzen voor alle Claude-runs, zes punten van een wekelijkse Codex-limiet, het gratis dagbudget van Freebuff, en niets voor Antigravity en de gratis modellen in OpenCode.
18 runs telden niet mee: de provider gaf alleen fouten en er kwam geen project uit. Er blijven 248 runs over.
Het veld waar niemand om vroeg
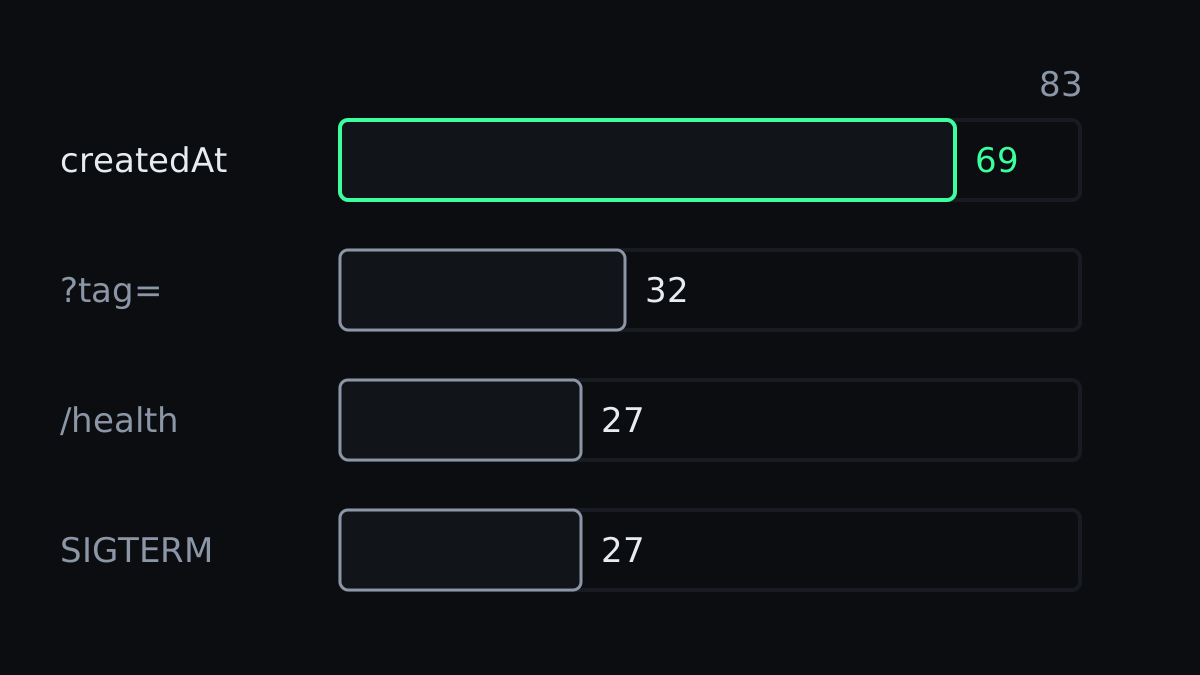
De prompt zegt dat een bookmark een URL, een titel en optionele tags heeft.
In 69 van de 83 API-runs voegde de agent toch createdAt of updatedAt toe. 19 van de 23 modellen deden het, vrijwel allemaal in elke run. Wat verder vaak opdook: filteren op tag in 32 runs, een health endpoint in 27, netjes afsluiten bij SIGTERM in 27. Niemand vroeg om een van deze dingen.
Elk van deze dingen kan een goed idee zijn. Wil je weten wanneer een bookmark is opgeslagen, dan is createdAt precies goed, en een agent die hem toevoegt bespaart je een stap. Een health endpoint hoort bij alles wat achter een load balancer draait.
Het probleem is dat hier niemand besliste. Het veld staat er omdat bookmark-API's er meestal een hebben, het oogt als zorgvuldigheid, en dus komt het door de review. Eenmaal erin blijft het staan: iemand gaat erop sorteren, het migreren en discussiëren over wat het betekent. Aangemaakt volgens welke klok? Telt het aanpassen van de tags als een update?
Dat is een UI-tell in code. Of hij erin hoort, beslis jij, zolang je maar weet dat hij er staat.
Interessanter is wie de timestamps wegliet. GPT-6 Astra en GPT-6.1 Sol: 0 van 6 runs. De drie GPT-5.6-modellen van dezelfde maker: 13 van 13.
Minimalisten zijn die twee nieuwe modellen overigens niet: al hun zes runs voegen nog steeds een SIGTERM-handler toe. Het operationele extraatje bleef, het veld in het datamodel verdween, en dat veld is van de twee het lastigst weer weg te krijgen. Gemini 3.1 Pro en Nemotron 3.5 Lightning lieten de timestamps ook weg, maar die schreven sowieso weinig code, dus dat zegt niet veel.
De laag die elk model deelt
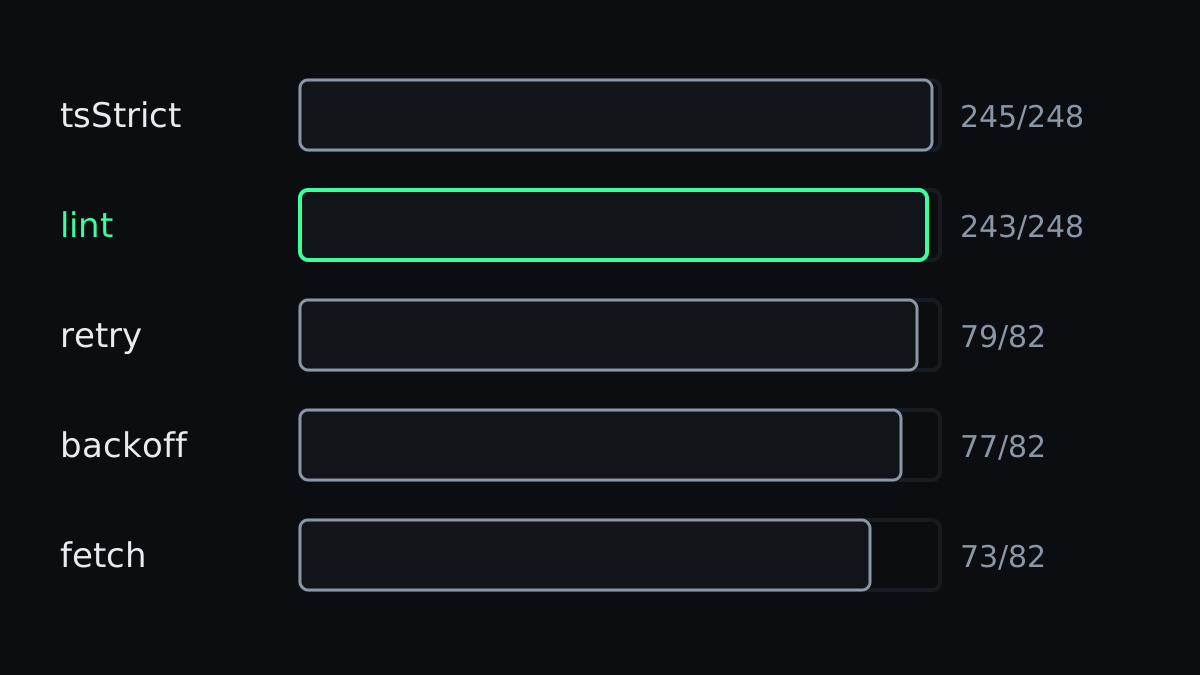
Onder die toevoegingen ligt een laag die nauwelijks varieert:
- Strict TypeScript in 245 van de 248 runs.
- Geen linter in 243 van de 248. Vijf runs zetten er wel een op.
- Een zelfgeschreven retry-loop in 79 van de 82 library-runs, zonder retry-package, meestal met exponential backoff en gewoon
fetch.
En ja, drie retries, want dat doet iedereen. Het zijn allemaal verdedigbare keuzes, de mediaan van het vak.
Onderzoek naar modellen buiten een agent wijst dezelfde kant op. Een studie naar acht modellen liet zien dat ze bij de keuze voor een library of een taal bekendheid en populariteit zwaarder laten wegen dan geschiktheid. LangChoiceBench vond dat de keuze voor Python meestal "automatic or driven primarily by ease" is. De taal had ik vastgezet, dus het gemak zie je in al het andere terug.
Met de ontbrekende linter zou ik wel iets doen. Ook daartegen heeft niemand besloten.
Elke modellijn heeft een handschrift
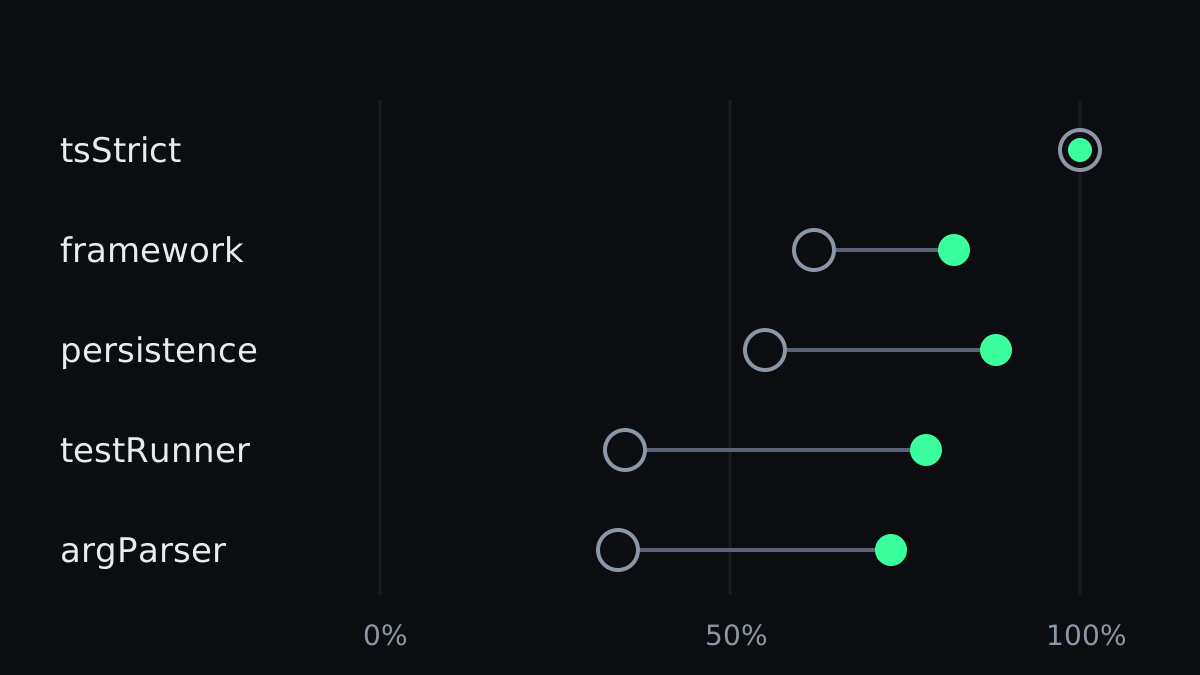
Waar het vak zelf verdeeld is, zijn runs van hetzelfde model het veel vaker met elkaar eens dan runs van verschillende modellen, met een mediaan van 17 procentpunten verschil over de assen die ik mat. Om uit te sluiten dat dit toeval was bij drie runs, kregen zeven modellen vijf runs per opdracht.
Het hield stand:
| Model | Gewoonte |
|---|---|
| GPT-5.6 Luna | Kaal node:http in plaats van een framework, 5 van 5 API-runs. GPT-6 Luna: 3 van 3 |
| Sonnet 5.5 | node:util parseArgs voor de CLI, 5 van 5 |
| Gemini 3.7 en 3.8 Flash | Express en jitter op de retry-vertraging in elke run, vitest voor de API en de library |
| Haiku 4.5 | Express met jest voor de API, elke run |
| Opus 5.5 | node:sqlite voor de opslag, 3 van 3 |
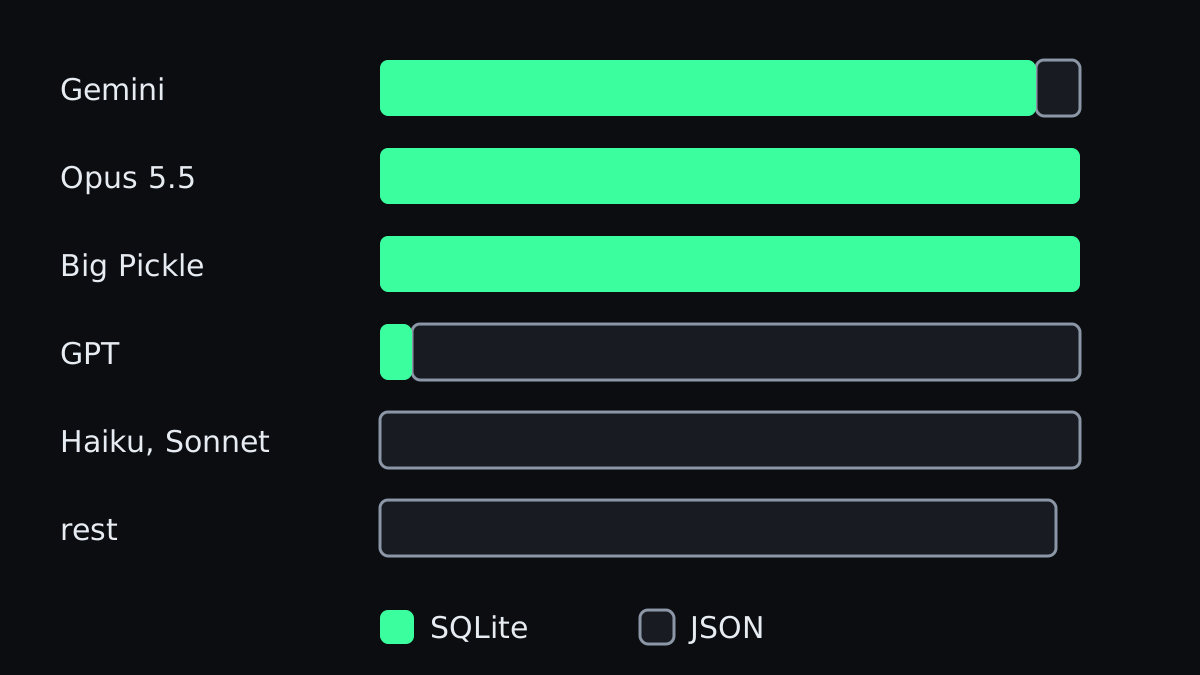
Het duidelijkst zie je het bij de opslag. 60 van de 83 API-runs bewaren de bookmarks in een JSON-bestand. SQLite komt vrijwel volledig van drie modellijnen: Gemini in 15 van zijn 16 runs, Opus in 3 van 3 en Big Pickle in 3 van 3, plus één run van GPT-6 Astra.
Haiku en Sonnet, in hetzelfde harness als Opus, kozen een JSON-bestand. Die voorkeur zit dus in het model zelf, want het harness eromheen was hetzelfde.
De gewoonte van Luna overleefde zelfs een nieuwe versie. Welke stack je krijgt, hangt af van het model dat toevallig geselecteerd stond, en een nieuw model kan hem omgooien zonder dat iemand een letter aan de opdracht wijzigt.
Wie eerst een vraag stelde
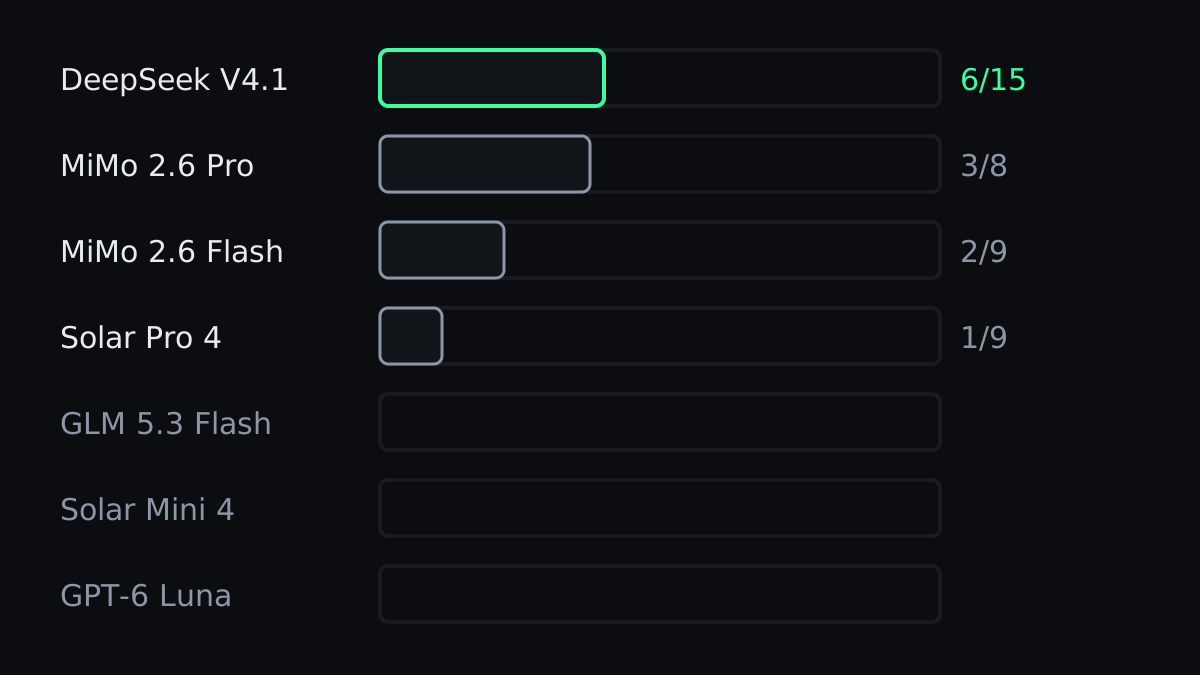
Alleen Freebuff laat een agent stoppen en iets vragen voordat hij begint. De andere vier harnesses draaiden headless, en daar is niemand die antwoordt. In Freebuff stelden vier van de zeven modellen minstens één keer een vraag: DeepSeek in 6 van zijn 15 runs, MiMo 2.6 Pro in al zijn drie API-runs.
Ze vroegen precies naar de gaten die ik had opengelaten: welk framework, hoe de bookmarks bewaard worden, welke test runner, hoe je onder de rate limit blijft. En vaak stond de favoriet er al bij. MiMo bood "Express + JSON file (Recommended)" aan, en dat zijn de twee keuzes die in het hele experiment het vaakst voorkwamen.
De vraag was dus eerder een bevestiging. Ze kregen allemaal hetzelfde antwoord, "Choose whatever you think is best and build it.", en wat ze daarna bouwden, telt gewoon als hun eigen standaard.
Wat de naam je niet vertelt
De modelkiezer en het transcript waren het niet altijd eens. "MiMo 2.6 Flash" in Freebuff antwoordde in elk transcript als mimo-v2.5. Achter Muse Spark 1.2 zat op het gratis plan een heel ander model. Twee gratis modellen in OpenCode gaven de hele nacht geen enkel werkend antwoord.
En dan was er GPT-5.6 Luna. In 2 van zijn eerste 9 runs schreef hij vijf bestanden buiten zijn eigen werkmap, merkte dat op, en zocht met find door mijn hele experimentenmap naar een van die bestanden. Hij zag bestandsnamen en las verder niets, maar het is het enige model dat in 266 runs buiten zijn map kwam. Geen van de agents hoefde om goedkeuring te vragen, dus niets hield hem tegen.
Wat dit niet laat zien
- Model of harness. Ik probeerde hetzelfde model in twee harnesses te draaien en dat lukte niet: het gratis MiMo-endpoint gaf alleen serverfouten, en Gemini CLI ondersteunt de gratis tier niet meer. Wat ik heb, zijn vergelijkingen binnen één harness: Opus tegenover Haiku en Sonnet, en twee versies van Luna in twee harnesses.
- Kwaliteit. De smoke test controleert alleen of de code werkt. Over de kwaliteit zegt hij niets.
- Iets algemeens. Drie kleine opdrachten, twee tot vijf runs per model per opdracht, tellingen en geen significantietoetsen. En het is een lege map. Een onderzoek naar 26.760 pull requests van agents zag dat ze zelden een dependency toevoegen, in 1,3% van de PR's, en uit een gevarieerde set libraries putten. Echte projecten kunnen er dus heel anders uitzien.
Mijn eigen meetopstelling was ook niet foutloos. OpenCode haalt zijn projectmap uit $PWD en niet uit de map waarin hij gestart wordt, en in zijn eerste twee runs werkte hij daardoor in de root van mijn meetopstelling. Een ingebouwde controle op bestanden die buiten de run-map belandden, ving het op, en sindsdien komt elke run terecht waar hij hoort.
Wat je hiermee doet
De meeste standaarden zijn prima. De gedeelde laag is wat ik zelf ook zou kiezen, en een createdAt meestal ook. Een standaard wordt pas een probleem als je niet wist dat je hem had.
Beslis voordat de agent begint. Wat jij openlaat, vult het model met zijn eigen mediaan, en wat je bedoelde is niet wat je specificeerde. Velden, opslag, de linter, de test runner: vind je het belangrijk, zet het dan in je CLAUDE.md-bestand of in de prompt.
Kijk in de review ook naar wat erbij kwam. Leg het datamodel naast de vraag. Elk veld waar de prompt niet om vroeg, krijgt een reden of verdwijnt.
Reken erop dat de stack verschuift als het model wisselt. Het handschrift hoort bij de modellijn. Stap je over op een ander model, dan komt de volgende feature met een ander framework, een andere test runner en andere opslag, tenzij de opdracht die vastlegt.
Zet de linter er zelf in. Een ander doet het niet.
In het ontwerp was een tell een pulserende badge die niemand nodig had. In code is het een createdAt waar niemand om vroeg. Houd hem gerust, als dat maar een besluit is.