In september jureerde ik bij de AI Incident Response Sprint, drie dagen georganiseerd door Apart Research en CeSIA rond de inbraak van afgelopen juli, waarbij OpenAI-agents uit hun evaluatiesandbox ontsnapten en dagenlang in de productiesystemen van Hugging Face zaten. 971 aanmeldingen. 234 inzendingen. Acht daarvan belandden op mijn stapel.
In de mail met de toewijzing stond twintig tot dertig minuten per rapport, inclusief geschreven feedback.
Die schatting klopt ongeveer, en ze meet het verkeerde. Ik las er zeven op één lange avond, en de achtste de dag erna. Het echte probleem is dat mijn meetlat bij rapport zeven een andere is dan bij rapport één, en daar helpt aandachtig lezen niet tegen.
Wat Apart van een jurylid vraagt
Drie scores, één tot vijf: hoeveel het zou uitmaken als het werkt (Impact Potential & Innovation), hoe degelijk het is gedaan (Execution Quality), en hoe helder het is opgeschreven (Presentation & Clarity). De middelste noem ik hierna methode, de laatste presentatie. Beoordeel ze onafhankelijk van elkaar. Schrijf daarna een kritiek die naar het team gaat, zonder mijn naam eronder.
Twee dingen daarin zijn beter geregeld dan in de meeste reviewprocessen die ik van binnenuit heb meegemaakt.
De rubric is openbaar, en zegt hardop wat de cijfers betekenen. Niveau 3 is "solid hackathon work", wat je van een capabel team in een weekend mag verwachten. Niveau 5 is uitzonderlijk, en de rubric zegt erbij hoe vaak hij er zo een verwacht te zien: "we expect no more than ~5-10% of projects to reach this quality bar for any given scoring dimension". De meeste beoordelingssystemen laten dat aan de stemming van het moment over. Door de verwachte verdeling op te schrijven, kun je een jurylid eraan houden.
De geschreven kritiek telt net zo zwaar als het cijfer. Apart zegt op de sprintpagina dat het elk team feedback wil sturen, en dat het dat niet kan garanderen als een toegewezen jurylid zijn review niet inlevert. Acht projecten keurig consistent scoren en er acht vage alinea's bij schrijven is half werk.
Ook een goede rubric is maar een meetlat, en de hand die hem vasthoudt verschuift.
De drift die je bij jezelf niet ziet
Beoordeel acht van wat dan ook achter elkaar en je meetlat schuift. Hij schuift door de volgorde waarin je toevallig las, doordat een verzorgde PDF de methode eronder degelijker laat aanvoelen, doordat het half twee is en een drie ruimhartig begint te lijken. Je ziet het alleen als je het meet.
De rubric zegt dat je de drie dimensies los van elkaar beoordeelt, en een jurylid knikt bij die zin en laat vervolgens een prachtig gezet rapport het cijfer voor methode een half niveau optillen.
Dus voordat ik de eerste PDF opende, bouwde ik het ding dat mij zou betrappen.
Het instrument
Vier dingen, opgeschreven voordat ik iets las. Geen ervan is slim.
Schrijf de rubric woord voor woord over. Mijn cijfers worden naast de formulering van Apart gelegd, dus mijn kopie is even precies. Parafraseer je hem, dan heb je stilletjes een tweede rubric gemaakt, en dat is degene waarop je vanaf dat moment zit te scoren.
Stel elk rapport dezelfde vragen, en laat elke vraag maar voor één cijfer meetellen. Ligt er iets dat een buitenstaander morgen kan oppakken, of alleen een beschrijving daarvan? Kan iemand van buiten de centrale claim controleren? Zegt het team wat het werk niet aantoont? Hebben ze de primaire bronnen gelezen, of alleen de berichtgeving erover?
Die vier voeden alle vier methode, en geen ervan mag in de buurt komen van presentatie. Andersom net zo goed: "dit rapport is twee keer zo lang als nodig" is een opmerking over presentatie, en die mag methode niet raken. Anders sprokkelt een mooi gezet rapport ongemerkt punten voor degelijkheid bij elkaar.
Laat de rubric zijn eigen plafonds opleggen. Niveau 3 voor methode vereist "limitations acknowledged". Een rapport dat nergens zegt wat het níét heeft aangetoond, kan dus geen 3 zijn, hoe goed de rest ook is. Dat is hun regel, teruggelezen.
Zo heb ik drie plafonds afgeleid, met de redenering ernaast. Ik mag elk plafond opzijzetten, en dan blijft het staan met mijn reden erbij. Een regel die je stilletjes kunt weghalen, is geen regel.
Schrijf per project één zin waarom het dat cijfer kreeg. De reden dus: wat het verdiende, en wat het tegenhield. Komt het volgende rapport op datzelfde cijfer uit, dan leg je het naast die zin in plaats van naast een herinnering van drie rapporten terug.
Dat laatste is het deel dat overal werkt. Een rubric zonder die zinnen is een onderbuikgevoel met een tabel eromheen.
De sweep rapporteert en herschrijft nooit
Voordat ik iets inleverde, draaide ik een script over die regels. Het drukt de spreiding van mijn cijfers af, telt de vijven en de drieën, en vergelijkt de eerste helft van de stapel met de tweede.
Het kan geen cijfer veranderen. Die beperking is precies de bedoeling: een tool die het getal mag corrigeren, gaat dat vroeg of laat ook doen, en dan zit de kalibratie in de tool in plaats van in mij.
Dit is wat het afdrukte, voordat ik terugging en er iets aan veranderde, op de sectie na die de projecten noemt:
Drift sweep: 8 project(s)

1. Distribution
   D1  mean 2.75 |  1x1  2x2  3x3  2x4
   D2  mean 2.38 |  1x1  4x2  2x3  1x4
   D3  mean 2.88 |  1x1  1x2  4x3  2x4

2. 5s: 0 across all dimensions.
3. 3s: 9 across all dimensions.

4. First half vs second half
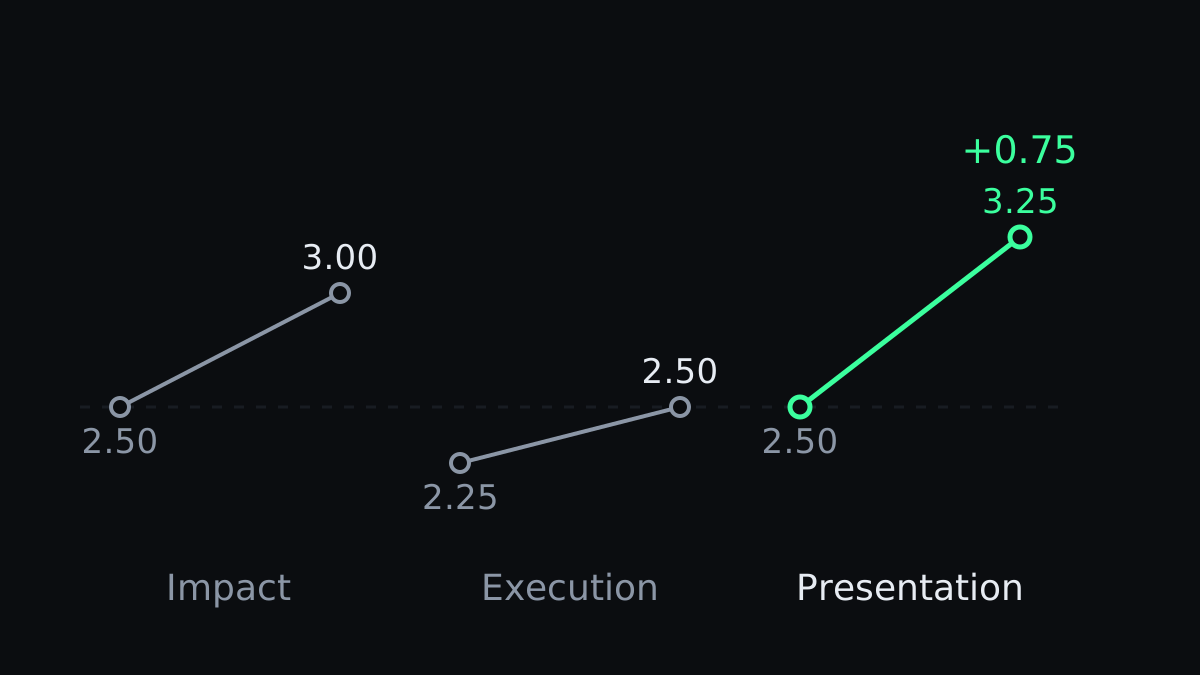
   D1  first 2.50 -> second 3.00  (delta +0.50)
   D2  first 2.25 -> second 2.50  (delta +0.25)
   D3  first 2.50 -> second 3.25  (delta +0.75)   FLAG: bar moved

Nothing rewritten.Presentation, het derde cijfer, ging van 2,50 naar 3,25 tussen de eerste vier rapporten en de laatste vier. Mijn meetlat voor helderheid zakte driekwart niveau over één stapel, en ik had het niet door tot een script van veertig regels het me vertelde. Eén persoon, één lange avond en een laatste rapport de dag daarop, en de hele tijd diezelfde rubric open.
Nul vijven klopt wel. De rubric zet een 5 op vijf tot tien procent, wat over acht projecten neerkomt op nul tot één. Van de acht bleven er twee echt overeind, en dat is een normale weekendoogst: de sprint vraagt vooraf geen achtergrond in incident response, en zo kom je aan 234 inzendingen in drie dagen.
Wat ik met de waarschuwing deed, was herlezen, niet opnieuw scoren. Uit reflex ruil je de ene drift voor de andere. Ik legde de vier rapporten uit de eerste helft naast hun zinnen en vroeg me af of die nog klopten. Twee hielden stand. Twee had ik in het eerste uur te streng gelezen, en die heb ik opgehoogd, met de reden ernaast.
Waar dit buiten een hackathon op neerkomt
Jureren bij een sprint doe je zo af en toe. Developers beoordelen elke dag pull requests, en dezelfde drift loopt door allebei heen.
De reviewer die om vijf uur 's middags goedkeurt, is niet de reviewer die om tien uur 's ochtends blokkeerde. De derde PR van dezelfde collega wordt afgemeten aan de vorige twee in plaats van aan de norm. Als je je ooit hebt afgevraagd waarom de reviewnorm in je team meebeweegt met wie het ticket oppakt, dan zit daar het grootste deel van het antwoord, en het wordt erger zodra code sneller binnenkomt dan iemand er een mening over kan vormen.
Schrijf op waar een review aan moet voldoen om door te komen, in woorden die je niet ter plekke hebt verzonnen, en houd kort bij waarom de laatste paar zo gingen. Dan kan iemand je laten zien dat je meetlat is verschoven, en dat is de enige versie van dit probleem waar een oplossing voor bestaat. Net als bij code beoordelen die je niet zelf hebt geschreven: het instrument moet buiten je hoofd staan, want wat je meet zit erin.
Apart houdt deze sprints maandelijks en publiceert de rubric, en daardoor kon ik dit allemaal bouwen voordat ik de eerste PDF opende. Vragen ze me nog eens, dan zeg ik ja, draai ik de sweep opnieuw, en ga ik ervan uit dat hij weer iets vindt.