Een versie van dit artikel voor een breder publiek verscheen eerder op Frankwatching. Deze is geschreven voor ontwikkelteams.
Mijn team gold als een van de productiefste. De onderbouwing was ons tokenverbruik: hoeveel AI we gebruikten, vergeleken met andere teams.
Ik ben lead developer van dat team, en we zetten AI in bij code die in productie draait. Dat we veel opleveren, klopt gelukkig wel. Alleen bewijzen die tokens daar niets van. Hetzelfde getal had net zo goed hoog kunnen staan bij een team dat weinig afmaakte.
Elk team dat met AI werkt, komt dus vroeg of laat bij dezelfde vraag uit: als verbruik niet laat zien wat AI oplevert, wat dan wel?
Waarom verbruik een doel werd
Het is het makkelijkste getal dat er is. Elke AI-tool rapporteert het, het past in één grafiek, en het gaat omhoog zodra een team de tool in gebruik neemt. Voor een manager die moet laten zien dat een investering iets oplevert, is dat verleidelijk.
Dit voorjaar gingen een paar grote bedrijven er helemaal in mee. Bij Meta bouwde een medewerker een dashboard dat collega's rangschikte op hun tokenverbruik, en dat ging in april offline. In mei haalde Amazon zijn scorebord weg, vanwege de kosten, en had Uber zijn budget voor 2026 voor AI-codingtools in vier maanden op. In augustus liet Microsoft zijn engineers in een interne mail weten dat het niet op tokenmaxxing stuurt, en zei de CTO van Uber dat het tijdperk van tokenmaxxing ten einde loopt. In het AI Impact Report 2026 van LeadDev vindt maar 19% van de ondervraagden tokenmaxxing effectief.
Het mechanisme is oud. Reken mensen af op een getal en ze gaan het getal verbeteren in plaats van het werk. Bij AI-verbruik zie je dat goed: het getal stijgt of er nu iets nuttigs gebeurt of niet, en de goedkoopste manier om het op te drijven is vaker iets vragen dan nodig is. Elk punt op zo'n scorebord staat bovendien op een factuur.
Een bruikbare maatstaf verbeter je dus niet door alleen meer te vragen.
Meer moeite, hetzelfde resultaat
Scoreborden meten mensen. Ik wilde weten of één opdracht beter wordt als je het model meer laat verbruiken.
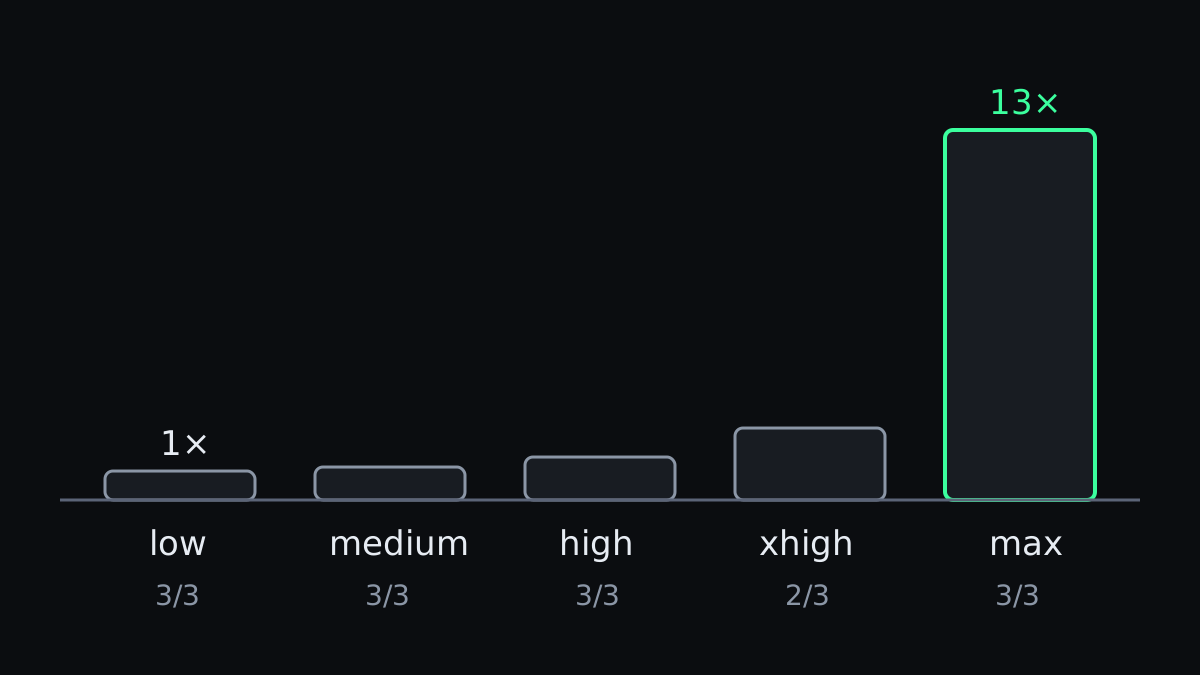
In Claude Code stel je met vijf effort-niveaus in hoe hard het model werkt, van low tot max. Ik gaf het model één kleine bugfix, een cache van 45 regels met meerdere fouten, terwijl het issue er maar één beschreef. Op elk niveau drie keer. Daarna controleerde ik elk resultaat met 13 tests die het model nooit te zien kreeg.
Veertien van de vijftien runs haalden alle 13 tests, ook alle drie de runs op low. De enige uitzondering loste op wat het issue vroeg en bood aan de rest ook te doen. max kostte 13 keer zoveel als low en duurde 20 keer zo lang. Op een token-scorebord wint hij met afstand. Reken je in kosten per afgeronde fix, dan betaalt hij dertien keer zoveel voor hetzelfde resultaat.
Het gaat om één kleine opdracht met één model, en over groot of vaag werk zegt het niets. Het laat alleen zien dat verbruik en resultaat los van elkaar kunnen bewegen. De volledige opzet en de cijfers staan in het verslag van de meting, en een groter onderzoek uit april naar acht modellen en honderden taken wijst dezelfde kant op: meer tokens leverden niet vaker een goed antwoord op.
De kosten schuiven naar de review
AI levert wel degelijk meer op. Een onderzoek bij Microsoft uit juli liet zien dat developers die met agents gingen werken, ongeveer een kwart meer wijzigingen opleverden. Een bedrijf dat twee keer zoveel wilde opleveren, haalde dat volgens een tweede onderzoek ook, zij het pas in de tiende maand, en de belasting per reviewer verdubbelde ongeveer mee.
De kosten verschuiven naar de review, en die staat op geen enkel scorebord.
Ik merk het elke dag. Ik review nu drie tot vijf keer zoveel code als vroeger, en veel wijzigingen hebben een paar rondes nodig voordat ze goed zijn. Er wordt meer gemaakt, en een flink deel daarvan moet twee keer door de review.
Drie maatstaven die je met meer vragen niet verbetert
- Kosten per gemergede wijziging. Wat een wijziging kost die in main is beland: de tool plus de uren van wie hem schreef, aanstuurde en reviewde. Stijgen de AI-kosten terwijl het aantal gemergede wijzigingen gelijk blijft, dan betaal je voor activiteit.
- Reviewtijd per pull request. Hoe lang een wijziging op review wacht en hoe lang de review duurt. Blijft die groeien terwijl er meer AI-werk binnenkomt, dan zit het knelpunt bij mensen, en maakt meer AI het erger. Dat is de reviewbottleneck in één getal.
- Herschrijven binnen twee weken. Hoeveel van wat gemerged is, kort daarna herschreven, teruggedraaid of opgelapt wordt. Werk dat terugkomt, telt niet als opgeleverd. Git heeft dit getal al: het is code churn.
Ook deze drie zijn te manipuleren, bijvoorbeeld door werk te mergen voordat het af is. Je laat ze alleen niet beter uitvallen door een model meer prompts te sturen, en daardoor zijn ze bruikbaarder dan een verbruikscijfer.
Waar je morgen mee begint
Vraagt iemand je om cijfers over AI-gebruik in je team, kies dan één soort wijziging die je team elke week oplevert. Houd een maand lang bij wat die kost, hoe lang de review duurt en hoe vaak die terugkomt. Dat is minder spectaculair dan een scorebord, maar het laat zien of de investering iets oplevert.
En vraag het eerst aan degene die alles moet reviewen. Die ziet het lang voordat een dashboard het laat zien.