Tegen het eind van zijn stuk over waarom OpenAI en Anthropic hun prijzen met tot 80% verlaagden schreef Max Woolf een zin waar binnen een dag antwoord op kwam: "I will be very curious to see the Anthropic IPO prospectus and the inference profit margins once it becomes public soon."
Vandaag diende Anthropic zijn S-1 in, en de marge staat niet in de winst-en-verliesrekening. In de loop van 2025 veranderde het bedrijf de presentatie van zijn cijfers, zodat cost of revenue en gross profit "are no longer presented as separate line items in the consolidated statements of operations." De cijfers staan er nog wel in. Je moet er alleen voor naar Note 8.
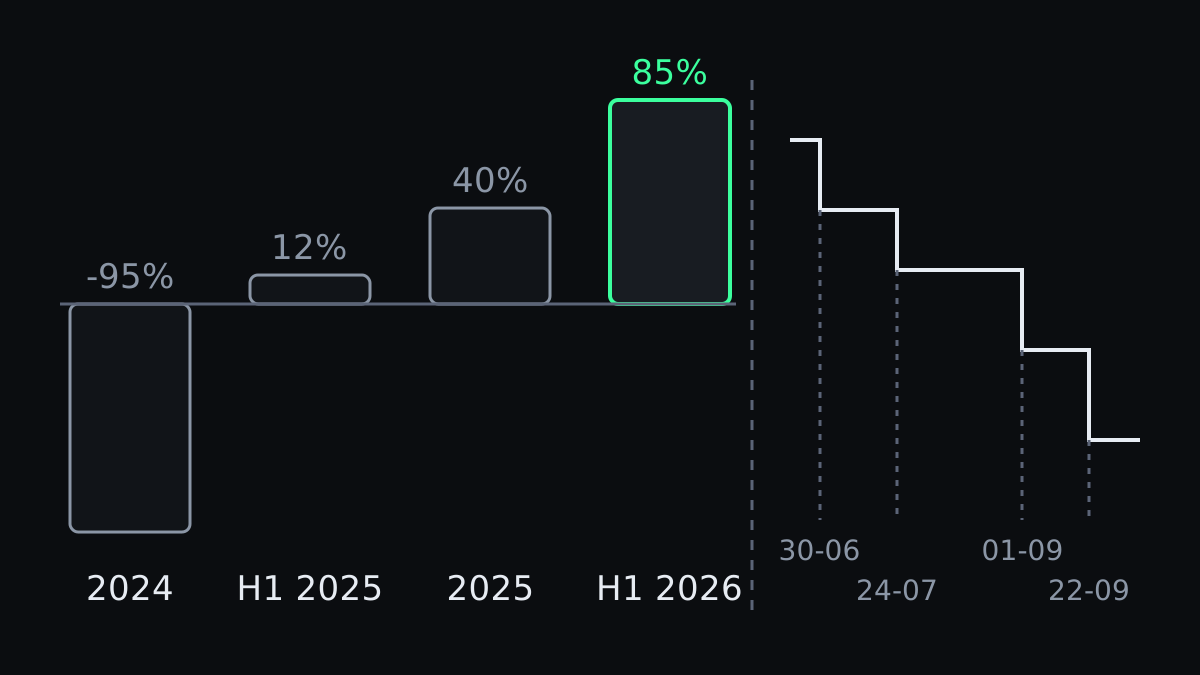
De marge die ze niet meer afdrukken
Note 8 noemt de cost of revenue nog, volgens de S-1 vrijwel helemaal "compute and infrastructure costs associated with customer-serving workloads." Zet je dat naast de omzet, dan heb je de marge op inference, het draaien van Claude voor klanten. De deling is van mij, de getallen zijn van hen:
| Periode | Omzet | Cost of revenue | Brutomarge |
|---|---|---|---|
| 2024 | $386M | $752M | -95% |
| H1 2025 | $1.163M | $1.019M | 12% |
| 2025 | $4.585M | $2.773M | 40% |
| H1 2026 | $16.286M | $2.380M | 85% |
In anderhalf jaar ging inference van verlies op elke dollar naar 85 cent marge per dollar.
Leg dat naast de tijdlijn van Woolf. Sonnet 5 kwam op 30 juni uit met een tijdelijke prijs die permanent werd. Opus 5 volgde op 24 juli. Fable 5.1 haalde op 1 september 75% van de prijs voor cache reads af. Opus 5.5 verscheen op 22 september voor $4 / $20 / $0,20. Elke verlaging valt op de laatste dag van het halfjaar dat al 85% marge haalde, of daarna.
Zo ziet een gesubsidieerde prijs er niet uit.
Wie denkt dat Anthropic marktaandeel koopt, heeft wel een punt. Het bedrijf als geheel speelt ongeveer quitte, met een operationele marge van min 4% in de eerste helft van 2026, omdat research and development $9,7 miljard kostte, vier keer zoveel als inference voor alle betalende klanten samen. En de concurrentie is echt: de S-1 waarschuwt zelf dat open-weight modellen "could exert pricing pressure on our offerings." Voor geen van beide hoeft een request onder de kostprijs verkocht te worden, en bij Anthropic zit de prijs er ruim boven.
Waar een lagere prijs per taak voor dient
De S-1 zegt het zonder omwegen: "Lower costs per task drive greater usage, which in turn drives broader diffusion of Claude. Our compute efficiency allows us to deliver these reductions while preserving our margins."
Het bewijs staat er direct bij. Opus 4.5 kwam in november 2025 uit met "a lower price and cost per task than its predecessor Opus 4.1," en de omzetgroei per kwartaal ging van 48% naar 132%. Opus 5.5 "reduced customers' cost per task by approximately 40% compared to Opus 5." De net revenue retention ligt op ongeveer 900%. De prijs per taak daalt, het aantal taken stijgt harder, en de rekening gaat omhoog.
De S-1 noemt zelfs wie daarvoor zorgt. Claude Enterprise-gebruikers zonder Claude Code gaven in het derde kwartaal gemiddeld minder dan $75 per maand uit. De top 5% van de gebruikers met Claude Code gaf ongeveer twintig keer zoveel uit.
In juni schreef ik over de overstap van Copilot naar betalen per verbruik dat tokenprijzen gesubsidieerd werden om je gewoonte te kopen. Voor de inference-kosten van Anthropic zegt de S-1 dat ik ernaast zat. Anthropic verdiende al aan die gewoonte, en volgens het prospectus zelf bleef de marge ook na de verlagingen overeind.
Waar het geld van een agent echt naartoe gaat
In de koppen staat de prijs voor output. Voor een coding agent is dat bijna een voetnoot. Woolf schat het aandeel van cache reads op "the vast majority (96% - 99%) of the total token expenditure" als je met een agent codeert, "as the cache is what contains the entire previous conversation each turn."
Mijn eigen transcripten zijn nog schever. In oktober stonden er ongeveer 800 cache read tokens tegenover elke output token. Elke beurt leest de hele sessie opnieuw: de system prompt, de CLAUDE.md, elk bestand dat de agent opende, elk tool-resultaat dat hij bewaarde.
De verlaging die telt, is dus die op cache reads. Opus 5.5 haalde 20% van input en output af, en 60% van cache reads, van $0,50 naar $0,20 per miljoen tokens. Fable 5.1 verlaagde alleen de prijs voor cache reads, en volgens Woolf is het model daardoor 70 tot 75% goedkoper in gebruik. Context opnieuw lezen is wat een agent kost, en juist die prijs zakte het hardst.
Daarmee verdwijnt ook de druk die sessies kort hield. Een uitgedijde sessie kostte vroeger geld. Nu kost hij vooral wachttijd en de aandacht van het model, en die staan op geen enkele factuur.
Mijn eigen teller bewoog niet
Voor mijn werk zit ik op Claude Max 20x, en dat betaalt mijn werkgever. Privé heb ik er Pro naast. Allebei een vast bedrag per maand, en op geen van beide facturen staat een regel voor tokens. Als de verlagingen al bij mij aankomen, dan als meer ruimte onder een limiet.
Mijn gebruik bewoog wel. Ik gebruik Claude al sinds Opus 3, maar de Claude Code-transcripten op deze machine beginnen op 21 september, de dag voordat Opus 5.5 uitkwam, en aan geen van beide abonnementen veranderde sindsdien iets. Van de eerste week tot vorige week is het aantal output tokens per week meer dan verdubbeld. Het model werd goed genoeg om er meer aan over te laten.
In de belangrijkste groeimaat van de S-1 tel ik niet mee: de net revenue retention laat "subscribers to our Claude Pro and Max plans" buiten beschouwing. Wat ik in plaats daarvan krijg, is een usage limit, en bij de risico's staat zonder omhaal wie daarover gaat: "We have also changed, and may in the future change, usage limits, rate limits, or model and product capabilities."
Als je de code zelf schrijft
Besteed de besparing aan het deel dat altijd al schaars was. Genereren werd al een tijd geleden goedkoop, en oordelen bleef duur.
- Steek de verlaging in verificatie. Tests vóór de wijziging, de suite bij elke beurt, een tweede reviewronde over de diff. Dat zijn precies de beurten die mensen oversloegen om tokens te sparen.
- Meet tokens per gemergede wijziging, uit je eigen transcripten, naast het totaal. De token-scoreborden lieten al zien dat elk getal op zichzelf een vertekend beeld geeft.
- Houd het begin van je context stabiel. Prompt caching werkt op het begin van de context, dus je instructies en je lijst met tools verander je niet midden in een sessie. Elke wijziging daar gooit het goedkope deel van elke volgende beurt weg.
- Reken je workflow één keer door tegen API-prijzen. Werkt hij alleen omdat een abonnementslimiet het vandaag toelaat, schrijf dat bedrag dan op.
Als je vibecodet
Voor jou verandert de rekensom het meest. Een nieuwe poging kost minder, dus je doet er meer, en elke poging leest een context opnieuw die bij elke mislukte poging is gegroeid. Prompten, draaien, de error plakken, opnieuw prompten: juist die lus draait harder op een goedkopere beurt, en zo beland je tussen de klanten die twintig keer zoveel uitgeven.
Met een abonnement zie je geen rekening. Je ziet de limiet, en de S-1 schrijft uit waar die naartoe leidt: abonnees "may utilize a higher subscription tier or purchase more intelligence directly." Die weg gaat maar één kant op.
- Begin een nieuwe sessie in plaats van door te bakkeleien met een vervuilde. Een korte context is goedkoop om te herlezen, en het model ziet je echte probleem in plaats van vijf mislukte fixes.
- Hanteer een stopregel. Na drie mislukte pogingen op dezelfde bug stop je met prompten en lees je de code. Kun je die niet volgen, dan is dit het moment om het deel te leren dat je oversloeg.
Wat je ook bent, houd een tweede route achter de hand, een open model of een tweede provider, zodat overstappen een configwijziging blijft. De S-1 noemt die druk een risico voor Anthropic, en daarmee is het jouw onderhandelingspositie. En reken erop dat de volgende verlaging je uitgaven verhoogt. Daar is hij voor.
Het eigen oordeel van Woolf over de verlagingen: "as a user I'm certainly not complaining!" De verkoper klaagt ook niet.