In augustus schreef ik dat mijn Claude Code-sessies geen klok hadden. Ik bouwde er een en sloot af met een belofte: vraag het me over een maand, dan heb ik een getal.
Dat is bijna zeven weken geleden. Hier is het, en het verraste me.
Ik ging ervan uit dat de agent zijn tijd aan denken besteedde. Een groot model, lang redeneren, een spinner die draait omdat er iets moeilijks gebeurt. In een maand aan eigen sessies was de hoofdagent 74 uur bezig met genereren en 117 uur met wachten op zijn tools. En een deel van die tijd zat de agent stil te wachten terwijl ik ergens anders was.
Hoe ik het heb gemeten
Claude Code schrijft elke sessie weg als JSONL-transcript, en elke regel daarin heeft een timestamp. Daarmee kun je bijna alles timen.
- Een tool call loopt van de regel waarin het model om de tool vraagt tot de regel waarin het resultaat terugkomt.
- Modeltijd loopt van elke input (mijn prompt, of een tool-resultaat) tot het laatste dat het model schrijft voordat het om de volgende tool vraagt. Ik stop de klok aan het eind van elke turn, zodat stilte tussen twee turns niet meetelt.
- Subagents houden hun eigen transcripts bij. Die heb ik apart gemeten.
De transcripts op mijn machine gaan terug tot 4 september. Tot en met 4 oktober zijn dat 127 sessies, 1.804 prompts van mij, 3.503 turns en 1.106 subagent-runs, op Claude Code 2.1.260 tot en met 2.1.289, bijna allemaal in auto mode.
Eén beperking geldt voor alles hieronder. De klok van een tool call loopt ook door tijdens een permissievraag die eraan voorafgaat, en die vraag staat niet in het transcript. Als een call twintig minuten "duurde", kan de agent dus een deel van die tijd hebben zitten wachten tot ik op ja klikte. Daar kom ik op terug.
De meeste tijd zit in de tools
De stappen van het model zelf zijn kort: een mediaan van 5,5 seconden tussen het binnenkrijgen van een resultaat en de vraag om de volgende tool.
De uren zitten ergens anders. Voor de hoofdagent, de hele maand bij elkaar:
| Waar de tijd heen ging | Uur |
|---|---|
| Model aan het genereren | 74 |
| Bash | 69 |
| Wachten op mijn antwoorden | 29 |
| Subagents op de voorgrond | 10 |
| De rest (Edit, Read, MCP, web) | 17 |
Opgeteld komen de tools op 125 uur. Sommige calls liepen tegelijk, dus op de klok gemeten wachtte de agent 117 uur op zijn tools.
Bij de subagents is het beeld nog uitgesprokener. Bash nam 48 van hun 55 tool-uren voor zijn rekening, 87%.
Van alles waar de agent op wacht, weegt de shell dus het zwaarst.
De helft van alle shell-tijd zit in 1,4% van de calls
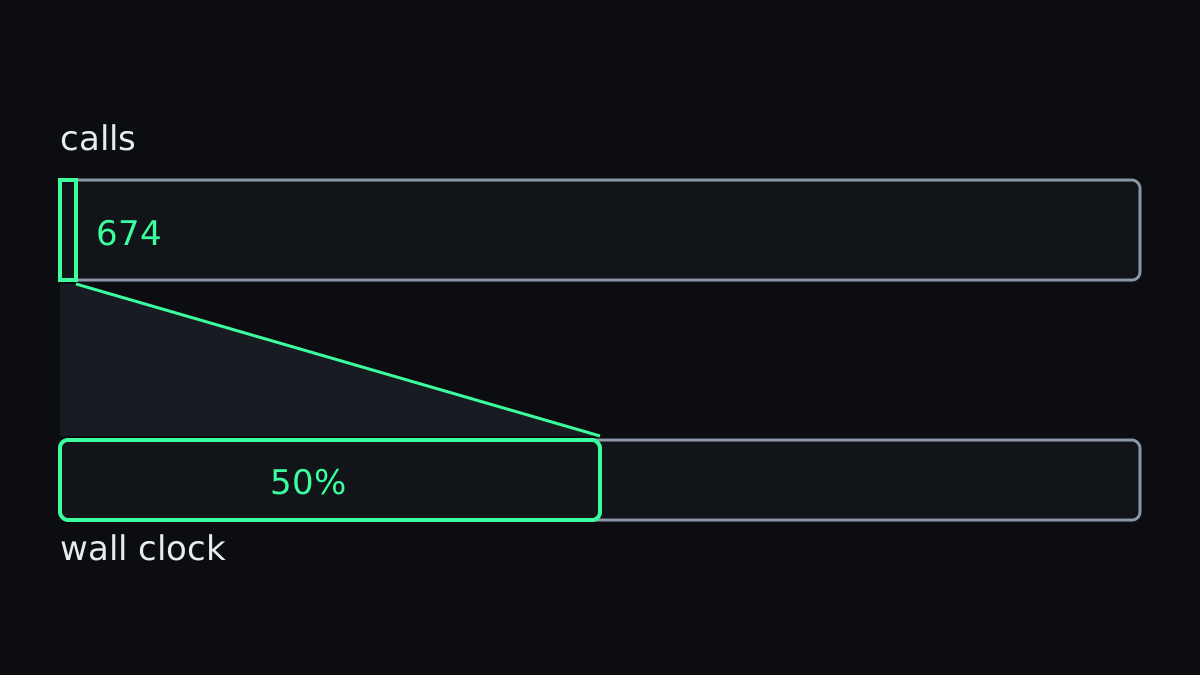
Hoofdagent en subagents samen draaiden 46.574 keer Bash op de voorgrond, goed voor 117 uur. De mediane call duurde 1,3 seconden, en negen op de tien waren binnen 9,8 seconden klaar.
Dan de staart. De traagste 674 calls, 1,4% van het totaal, zijn goed voor de helft van alle Bash-tijd. De 1.420 calls die langer dan een minuut liepen, kwamen samen op 76 uur: bijna twee derde.
Gesorteerd op wat het commando deed:
- Tests: 22 uur, een vijfde. Geen verrassing en geen spijt. Een suite die tijd kost, doet zijn werk, en een agent die hem draait, is precies de bedoeling. In turns waarin getest werd, was de mediaan twee runs. Het record was 77 in één turn van 69 minuten: een fix-loop in een van mijn eigen projecten.
sleepen polling loops: 12,6 uur. Meestal is dat de agent diesleep 60schrijft of eenwhile-loop om een statuscheck heen zet, en daarmee het hele gesprek blokkeert tot die klaar is.- Lezen en zoeken (
cat,grep,find): 19 uur, scripts 16, git 11,for-loops 10, builds en typechecks 3. - Een vijfde kon ik niet indelen: samengestelde one-liners die in één call een
cddoen, een variabele zetten, een loop draaien en door een pipe gaan.
Die sleep-uren zitten me het meest dwars, want de oplossing bestaat al. Claude Code kan een commando op de achtergrond draaien en de agent laten weten wanneer het klaar is. In die maand gebeurde dat 690 keer. Daartegenover staan 1.420 calls die de voorgrond langer dan een minuut bezet hielden.
Mislukte calls kosten bijna niets
In die maand mislukten 1.277 tool calls. De grootste groep, 518, waren shell-commando's die met een foutcode stopten. Samen kostten de mislukte calls 8 uur. Een fout valt op in het transcript, maar nauwelijks op de klok.
Een paar lange turns slokken de uren op
Bij de turns zie je dezelfde lange staart als bij de shell-calls. Meer dan de helft, 1.892 stuks, was binnen een minuut klaar, en samen zijn die goed voor 5% van alle turn-tijd.
Aan de andere kant liepen 39 turns langer dan een uur. Die 39 nemen samen 38% van alle turn-tijd voor hun rekening. Alles boven een kwartier, 205 turns, is samen twee derde.
Hoe het werken met de agent aanvoelt en wat het aan uren kost, zijn dus twee verschillende dingen. Wat ik zie, is vooral een snel heen-en-weer. Wat de klok registreert, is vooral een paar lange stukken.
De traagste tool ben ik
De agent wachtte 29 uur op AskUserQuestion, de tool waarmee hij me een meerkeuzevraag voorlegt.
Hij stelde 468 vragen in 382 calls. Het mediane antwoord kwam na 53 seconden, en 205 calls had ik binnen een minuut beantwoord. Zit ik achter mijn bureau, dan kost een vraag minder dan een minuut.
Zit ik er niet, dan kost hij uren. Twee vragen wachtten elk meer dan een uur, samen 9,4 uur. Er was niemand om ze te beantwoorden.
Hetzelfde zit verstopt in de klok van de tools. Een Edit duurt milliseconden, en toch "duurden" 42 edits en writes langer dan een minuut, samen 1,9 uur. Die minuten zijn vrijwel zeker permissievragen: een edit in een bestand dat een hook bewaakt, een write buiten het project.
Die 1,9 uur is een ondergrens. Een Bash-commando dat op toestemming wachtte, ziet er precies zo uit als een Bash-commando dat lang draaide, en in 117 uur shell-tijd kan ik die twee niet uit elkaar halen. Elk getal in de trant van "Bash is het grootste deel van je tool-tijd", ook dat van mijn eigen plugin, bevat een paar van mijn koffiepauzes.
Twee sessies tegelijk vangen een deel van het wachten op
De hoofdagents draaiden samen 283 uur aan turns, en op de klok was dat 231 uur. Gedurende 44 van die uren werkten er twee of meer sessies tegelijk.
Dat is het tegenwicht voor alles hierboven. Ongeveer een vijfde van de drukke tijd was er meer dan één agent aan het werk, dus als de ene sessie wachtte, lag niet alles stil.
Wat ik heb veranderd
Een sneller model lost hier niets van op. Wat helpt, is zorgen dat het wachten niet meer blokkeert.
- Lange commando's naar de achtergrond. Een testsuite, een build of een run op een andere machine krijgt
run_in_background, en de agent gaat iets anders doen of rondt zijn turn af. Eén regel inCLAUDE.mdvraagt erom. Is vragen niet genoeg, dan zijn daar hooks voor. - Geen
sleeploops. Wachten op CI of een deploy laat je over aan een watcher op de achtergrond die de agent seint als er iets verandert. Een loop op de voorgrond legt het hele gesprek stil. - Vragen voordat ik wegga. Heeft de agent straks een beslissing nodig, dan moet hij erom vragen terwijl ik er nog ben. "Vraag nu alles wat je nodig hebt en werk daarna zelfstandig door" is een prima prompt.
- Een tweede sessie voor het lange wachten. De overlap ving deze maand al 52 uur aan turn-tijd op. Met een worktree per sessie zitten twee agents niet in elkaars bestanden.
- Minder permissievragen voor wat veilig is. Elke permissievraag is een plek waar de agent kan blijven hangen. In de permissions goed instellen staat hoe je toestaat wat veilig is, zodat alleen de vragen overblijven waarvoor stoppen de moeite waard is.
Of de agent geholpen heeft, zeggen deze getallen niet. Ving een testrun van twintig minuten een regressie, dan waren dat twintig goed bestede minuten. Maak je van deze getallen een doel, dan ben je weer het verkeerde aan het meten.
Wel weet ik nu waar de middag bleef. Minder in denken dan ik dacht, veel in een shell die op een testsuite wachtte, en verrassend veel in wachten op mij.