Scroll terug door een Claude Code-sessie en probeer een simpele vraag te beantwoorden: hoe lang duurde die refactor?
Je vindt hooguit losse stukjes. Aan het eind van een beurt zet Claude Code er een regel onder, ✻ Sautéed for 23s · done 6:05 PM. Met Ctrl+O open je de transcriptweergave, waarin elk bericht van de assistent een timestamp heeft. En het sessieblok in /usage, bedoeld voor API-gebruikers, geeft de totale duur.
Geen van de drie beantwoordt je vraag. Een refactor van negen beurten is negen regels om zelf op te zoeken, en nergens staat hoeveel van die tijd de agent bezig was en hoeveel jij aan de lunch zat.
De eerste versie van deze post beweerde dat je dit nergens op je scherm kon zien. Claude Code toonde de duur toen al, en dat is een mooie fout om te maken in een post over niet opletten.
Het gemis is me een keer of twintig opgevallen voordat ik er iets aan deed. Meestal terwijl ik voor een factuur een middag probeerde te reconstrueren, of de vraag "is dat nou echt sneller geworden?" met een schouderophalen beantwoordde.
Dus heb ik de klok gebouwd
Timestamps (voorheen claude-timestamp) is een plugin voor Claude Code en Codex. In Claude Code zet hij aan het begin van elk bericht van de assistent een markering: de lokale tijd, en hoe lang de beurt duurde vanaf het moment dat jij op enter drukte. De toolpagina beschrijft de functies, de ondersteuning per client en de configuratie.
[13:22:13 +2m14s] I've updated the migration and re-run the suite.Zodra een beurt een grens overschrijdt die je zelf instelt, verandert de duur van kleur, zodat een trage beurt meteen opvalt. Loop je een uur weg, dan krijgt die onderbreking een eigen regel, waardoor een sessie die je de volgende ochtend weer oppakt nog steeds op volgorde te lezen is. Bij het afsluiten krijg je te zien wat de sessie gekost heeft:
Session lasted 1h30m over 12 turns, 24m18s of it waiting, 35m00s away.
slowest tools: Bash 41.2s (18 calls), WebFetch 8.1s (1 call), Read 2.0s (37 calls). 2 failedInstalleren doe je met twee commando's. Start daarna een nieuwe sessie, want hooks worden gekoppeld zodra een sessie begint.
claude plugin marketplace add https://github.com/AraneaDev/aranea-marketplace
claude plugin install timestamps@araneaDe dependencies zijn jq en bash. Met /timestamps:configure tokyo of /timestamps:configure 12 hour clock pas je instellingen aan vanuit de sessie zelf, zonder ook maar iets te herstarten.
Codex heeft geen event om de weergave van een bericht aan te passen, dus daar krijg je geen markering, wel de meldingen voor de agent, de geschiedenis en de totalen.
De tweede regel van dat sessierapport heeft TOOL_TIMING nodig, en die staat standaard uit. Dat is een van de vier instellingen die iets kosten per tool call, een paar milliseconden op de machine waarop het gemeten is. De andere drie staan wel aan, omdat de meldingen aan de agent ze nodig hebben.
Het model weet het ook niet
Wat me meer verbaasde: de agent heeft geen besef van verstreken tijd.
Een gesprek is voor het model een lijst berichten waar geen tijd bij staat. Het weet welke dag het is, want dat vertelt Claude Code het. Het heeft geen idee of jouw vorige bericht dertig seconden geleden binnenkwam of afgelopen dinsdag.
Vraag hoe lang dat laatste Bash-commando duurde en het gokt, met dezelfde stelligheid waarmee het al het andere gokt. Claude Code meet die duur wel, maar geeft hem aan hooks. De context is een transcript, en een transcript kent geen tijd.
De uitzonderingen zijn beperkt. Het resultaat van een subagent bevat zijn duur, een geheugenbestand bevat wanneer Claude het schreef, en de agent kan altijd date draaien. Dat laatste zegt hoe laat het nu is, en niets over hoe lang iets duurde.
Vraag je een agent dus om over tijd te redeneren, dan vraag je dat aan een systeem zonder wereldmodel, dat van die dimensie alleen kruimels krijgt.
Aan beide kanten van het gesprek wordt gegokt. Jij hebt een duur per beurt en je herinnering aan de rest. Het model heeft minder.
Twee hooks, twee lezers
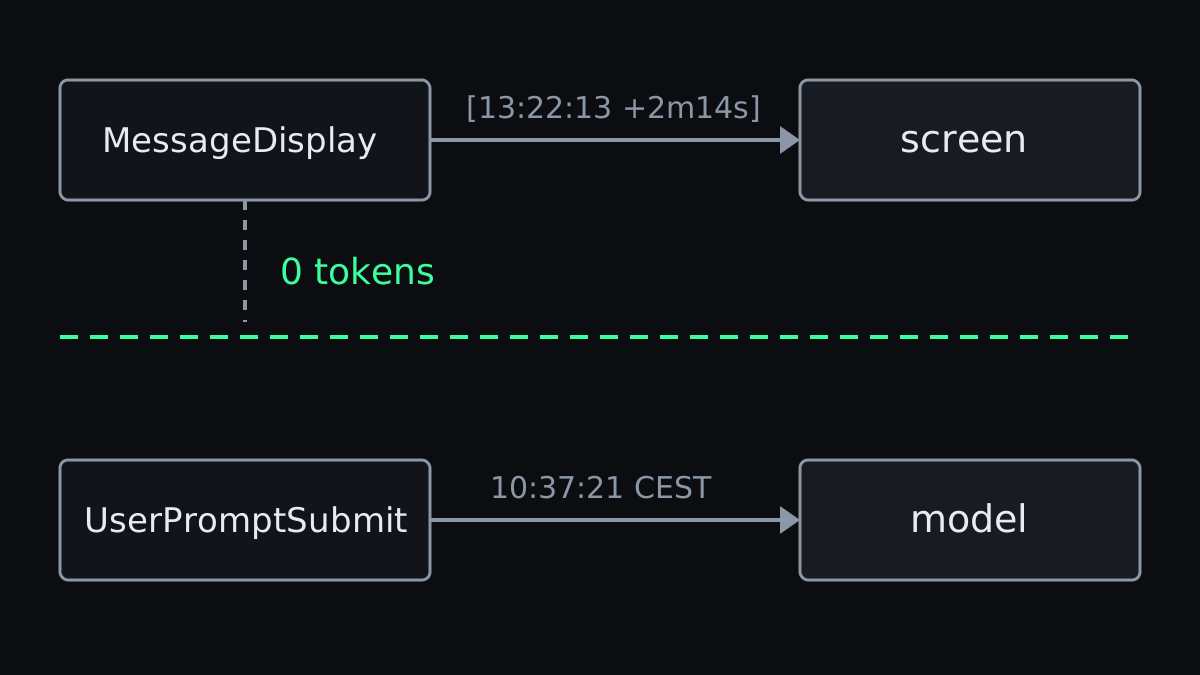
Het ontwerpidee dat je gerust mag overnemen, heeft niets met klokken te maken.
De markering die jij ziet, komt van een MessageDisplay-hook, die volgens de documentatie van Claude Code alleen de weergave verandert. Hij vervangt wat er op je scherm verschijnt en laat het opgeslagen transcript en wat het model te zien krijgt ongemoeid. De timestamps kunnen Claude dus niet in de war brengen, kunnen niet worden aangezien voor zijn eigen tekst, en kosten geen context.
De tijd die het model wél krijgt, loopt via een apart kanaal: een UserPromptSubmit-hook die één regel toevoegt met het moment waarop de prompt verstuurd werd. Die regel bereikt het model wel: hij wordt als context achter je prompt geplakt, los van wat jij typte, zodat het model hem als metadata leest. De datum blijft eruit, want die krijgt het model al van Claude Code en daar twee keer tokens voor betalen is zonde.
Sinds augustus gaat er meer door dat kanaal. De agent hoort het nu als een beurt langer dan een kwartier loopt, als een tool call een minuut of langer duurt, en hoe lang een traag commando in dit project normaal duurt:
That Bash call took 6m10s (usually 4m02s).Die meldingen geven alleen feiten. Wat de agent ermee moet, staat in een meegeleverde skill.
Het zijn bewust twee mechanismen voor twee verschillende lezers, en je kunt het ene uitzetten zonder aan het andere te komen. Heb je je ooit afgevraagd welk mechanisme je waarvoor pakt, dan is dit een helder voorbeeld van "allebei, voor verschillend werk". De gids over hooks behandelt de levenscyclus waarop ze inhaken.
Nog één ding over de implementatie, want daar deed ik langer over dan ik wil toegeven. MessageDisplay wordt herhaaldelijk aangeroepen terwijl een bericht binnenstroomt, telkens als er weer een blok regels af is. Alleen het eerste blok krijgt een stempel. Bij de rest geeft de hook helemaal niets terug, en dat is volgens de documentatie precies de manier om de originele tekst te laten staan.
De tekst ongewijzigd terugsturen zou bij elk blok van elk bericht verspild werk zijn geweest: een merkwaardige manier om te betalen voor een functie die juist bestaat om te laten zien waar je tijd blijft.
Niemand meet het, ook de mensen die het meten niet
Dat weegt zwaarder dan je van een ontbrekende timestamp zou verwachten, want de hele discussie over de vraag of coding agents je sneller maken, drijft op wat mensen zelf rapporteren.
METR publiceerde het cijfer dat iedereen aanhaalt: ervaren open-source-ontwikkelaars deden er 19% langer over met AI-tools, terwijl ze dachten 20% sneller te zijn geweest. Dat resultaat komt uit begin 2025, en METR heeft het inmiddels zelf als verouderd gemarkeerd, met een vervolg dat in februari 2026 verscheen. Handig om te weten voordat je het cijfer bij de volgende stand-up van stal haalt.
Interessant aan dat vervolg is waarom METR de eigen data "an unreliable signal" noemt. De belangrijkste reden: ontwikkelaars die niet meer zonder AI willen werken. Maar de update van februari 2026 noemt de tijdmetingen ook "unreliable for the fraction of developers who use multiple AI agents concurrently", en zet dit bij de minder ernstige problemen: "Some developers reported it was challenging to report time-spent in completing tasks when they used agentic tools, because they would often work an unrelated task while waiting for the agent to complete its work."
Een onderzoeksorganisatie die een gecontroleerd experiment uitvoert en ontwikkelaars 50 dollar per uur betaalt, kreeg niet van iedereen die met agents werkt betrouwbare tijdmetingen. Omdat mensen iets anders gaan doen terwijl de agent werkt. Precies wat jij ook doet, en jou betaalt niemand 50 dollar per uur om het op te schrijven.
Alles wat iemand je vertelt over de snelheid van agents, inclusief wat je jezelf vertelt, is een herinnering aan een draaiend bolletje.
Wat de cijfers zeggen, en wat niet
Toen deze post voor het eerst verscheen, was het geschiedenisbestand die middag pas aangemaakt en had ik precies één opgeslagen sessie: 27 minuten, vijf beurten, tien en een halve minuut daarvan wachten. Bijna 40% van die sessie zat ik naar een cursor te kijken.
Eén sessie bewijst niets, en daar gaat het nou juist om. Daarom sloot ik af met een belofte: vraag het me over een maand, dan heb ik een getal.
Het werden bijna zeven weken, en het getal kwam uit een maand van mijn eigen sessies: 74 uur genereren tegenover 117 uur wachten op tools. Dat is meer dan de meeste mensen hebben die op internet over de productiviteit van agents discussiëren.
Wees alleen voorzichtig met wat je ermee doet. Wachten is geen productiviteit, en uit de samenvatting blijkt niet of de agent geholpen heeft. Een beurt van vier minuten die een correcte migratie oplevert, is meer waard dan een beurt van twintig seconden die een plausibel ogende puinhoop oplevert. Maak je van "wachttijd" een getal dat je gaat optimaliseren, dan heb je het verkeerde meten opnieuw uitgevonden, in een andere eenheid.
Wat het je wél vertelt, is waar je aandacht heen ging. Bij welke sessies je zat te wachten. Welke tools de meeste tijd opslokken. Of die middag die productief aanvoelde, bestond uit een halfuur werk en twee uur wachten, of andersom.
De klok maakt je niet sneller. Hij zorgt er alleen voor dat je niet meer hoeft te gokken.