In mei schreef ik dat Superpowers de zuinige manier is om met Claude Code te werken, en ik vatte het samen in één regel: "Plannen is goedkoop, uitvoeren is duur."
Gemeten had ik dat nooit. Nu wel, voor het deel van Superpowers dat het meeste werk doet: subagent-driven development, de skill die elke taak uit een plan aan een verse subagent geeft en een andere subagent het resultaat laat reviewen.
Het uitvoeren bleek goedkoop. Alle code, alle rapporten en alle reviews samen waren 0,06% van de tokens. De rest ging op aan modellen die hun eigen context opnieuw lazen, beurt na beurt. En de verse subagent die de methode zo aantrekkelijk maakt, bleef alleen goedkoop zolang zijn taak klein bleef.
Wat subagent-driven development doet
Je geeft de skill een implementatieplan. De sessie waarin je begon, wordt de controller. Per taak schrijft die een brief, stuurt een implementer-subagent op pad, laat een task reviewer het resultaat toetsen aan de spec en op kwaliteit, en draait een fix-loop van hooguit vijf rondes, met na elke ronde een gerichte re-review. Als alle taken af zijn, kijkt nog één reviewer naar de hele branch, op het sterkste model.
De skill vat zichzelf samen als "Fresh subagent per task + task review (spec + quality) + broad final review = high quality, fast iteration".
Waarom het een goed idee is
Het ontwerp klopt. Een implementer ziet nooit de geschiedenis van de sessie, alleen zijn brief, dus iets wat je twee uur eerder zei, kan hem niet op een zijspoor zetten. Elke taak wordt gereviewd zolang de diff nog klein is. En een ledger-bestand houdt bij welke taken af zijn, zodat een controller die de draad kwijtraakt verder kan waar hij gebleven was.
De skill is ook eerlijk over waar de tokens heen gaan. Hij waarschuwt dat alles wat je in een dispatch plakt, en alles wat een subagent terugmeldt, "stays resident in your context for the rest of the session and is re-read on every later turn." En hij zegt het onomwonden: "Wall-clock and context cost scale with how many turns a subagent takes". In die twee zinnen zit het hele verhaal.
Hoe ik telde
Claude Code schrijft elke sessie weg als JSONL-transcript, en bij elke model call staat het tokenverbruik. Subagents houden hun eigen transcripts bij, in een map ernaast.
Ik nam elke call naar de skill tussen 15 september en 15 oktober: elf plannen in zes van mijn eigen repository's, op Claude Code 2.1.272 tot en met 2.1.300 en Superpowers 6.3.0 en 6.4.1. Alleen model calls tijdens een lopend plan tellen mee, bij de controller en bij de subagents. Een plan begint bij de call naar de skill en eindigt bij de volgende stap in de workflow, zoals de branch afronden of een nieuwe brainstorm. Had een sessie zo'n stap niet, dan legde ik het einde met de hand bij de laatste review van het plan.
Eén plan was in drie branches geforkt, en een fork kopieert zijn geschiedenis, dus ik telde elke model call één keer, op zijn message-id. In dezelfde valkuil trapte ik eerder bij de telling van auto mode.
Die afbakening kostte twee pogingen, en een verse agent die mijn cijfers natrok, haalde beide fouten eruit. Mijn eerste telling rekende alles na de call naar de skill toe aan het plan, en mijn tweede liet elk plan nog doorlopen tot het einde van de sessie. Beide keren zag ik over het hoofd dat een sessie vaak nog doorloopt als het plan klaar is. Op 2 oktober ging ik na de laatste review nog een dag door en stuurde ik "rondes" met verbeteringen naar Opus-subagents. Dat alleen al kostte 1,6 miljard tokens die bij geen enkel plan hoorden.
Schrijven valt weg in de afronding
De elf plannen stuurden samen 407 subagents op pad en verbruikten 3,3 miljard tokens.
De output, alles wat welk model dan ook schreef, was daar 2,1 miljoen van: 0,06%. De rest was input, en bijna al die input was cache read. Bij elke beurt leest een model zijn complete context opnieuw: de instructies, elk bestand dat het opende, elk tool-resultaat, elk woord dat het eerder schreef. Een context van 400.000 tokens die 300 beurten lang wordt gelezen, is 120 miljoen tokens, wat het model er ook tussendoor schrijft.
Werk je met een abonnement, waarvan de gebruikslimieten in tokens worden gemeten, dan is de vraag dus hoe groot elke context wordt en hoeveel beurten hem lezen.
De controller neemt een derde
De controller schrijft geen code en nam 35% van de tokens voor zijn rekening: 1,18 miljard. Hij schreef bovendien ruim drie keer zoveel output als alle 407 subagents samen, 1,7 miljoen tegenover 0,5 miljoen.
| Start | Dispatches | Controller | Subagents | Aandeel controller |
|---|---|---|---|---|
| 15 sep. | 45 | 111M | 162M | 41% |
| 18 sep. | 36 | 101M | 69M | 59% |
| 19 sep. | 29 | 151M | 69M | 69% |
| 21 sep. | 35 | 42M | 107M | 28% |
| 25 sep. | 22 | 68M | 123M | 35% |
| 2 okt. | 38 | 80M | 93M | 46% |
| 4 okt. | 46 | 66M | 270M | 20% |
| 6 okt. | 18 | 29M | 19M | 60% |
| 7 okt. | 101 | 426M | 1.158M | 27% |
| 11 okt. | 19 | 44M | 65M | 40% |
| 12 okt. | 18 | 65M | 25M | 72% |
Van de tokens van de controller is 98,9% cache read. In zijn context staan het plan, elke brief die hij schreef, elk rapport dat terugkwam en elk oordeel van een reviewer, en per plan las de mediane beurt van de controller tussen grofweg 250.000 en 625.000 tokens.
Dat leest hij, als mediaan over de plannen, zo'n zes keer voor elke subagent die hij op pad stuurt. Elke dispatch betekent een brief of diff klaarzetten, die versturen en lezen wat er terugkomt, en tussendoor de ledger bijwerken.
Een verse subagent is goedkoop zolang de taak klein is
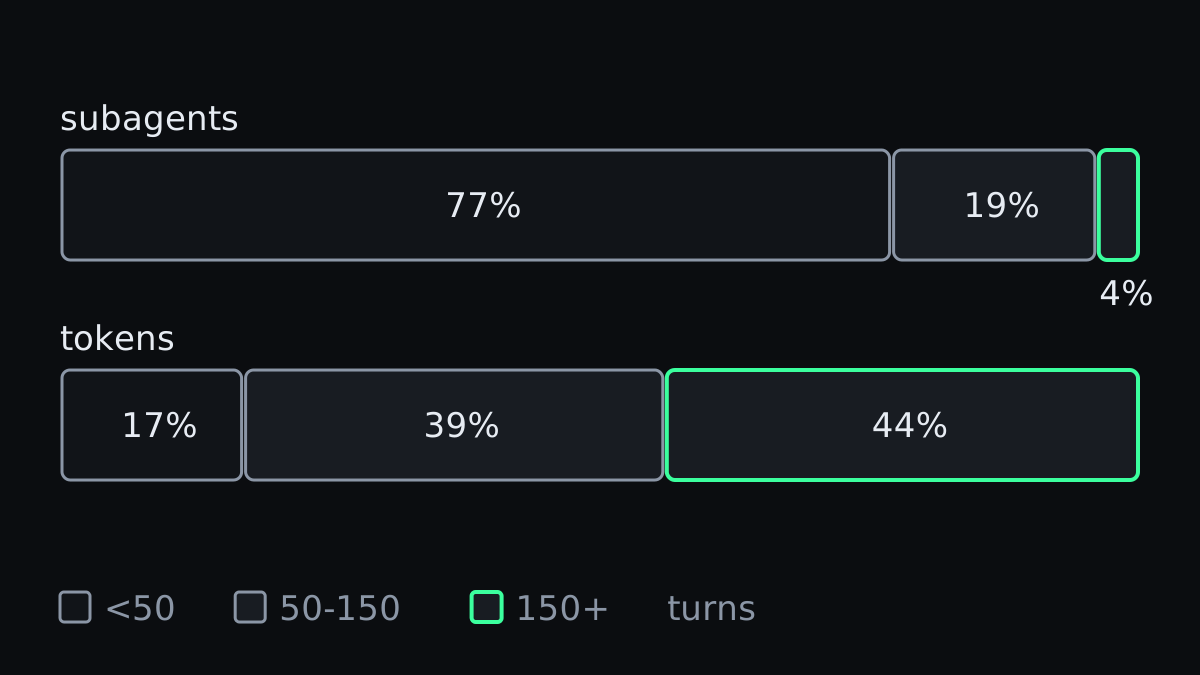
De andere 65% ging naar de subagents, en die is allesbehalve gelijk verdeeld. In de 366 subagent-transcripts met tokens binnen het venster van een plan draaide de mediane subagent 19 beurten en verbruikte hij 1,4 miljoen tokens.
| Beurten | Subagents | Aandeel subagent-tokens | Mediane tokens | Mediane piekcontext |
|---|---|---|---|---|
| minder dan 50 | 280, 77% | 17% | 0,8M | 78k |
| 50 tot 150 | 70, 19% | 39% | 9,7M | 179k |
| 150+ | 16, 4% | 44% | 50M | 395k |
Vier procent van de subagents verbruikte 44% van de tokens. De tien grootste samen al 34%.
Het patroon is gewoon rekenwerk. De context van een subagent die lang doorloopt, groeit bij elke beurt, en elke beurt leest hem helemaal opnieuw, dus de tokens groeien veel harder dan het werk. Een subagent van 365 beurten wordt een tweede controller, en de grootste in mijn data las in zijn eentje 147 miljoen tokens, meer dan de complete controller van negen van de elf plannen.
Ik weet waar de uitschieters vandaan kwamen: elk ervan kreeg meer dan één taak mee. De grootste was "implementing PR 1 (Tasks 1 and 2) of the Phase 4 workers plan". Een andere kreeg zes taken uit een herstelfase in één keer, "Batch 3 (Tasks 7-9 ...) and Batch 4 (Tasks 10-12 ...)", omdat mijn controller ze in één pull request had gebundeld. Die draaiden op Opus 5.5, 200 tot 365 beurten lang, en vijftien van de zestien subagents boven de 150 beurten waren Opus 5.5.
Eén vertekening krijg ik er niet uit: de skill draagt de controller op om zwaardere taken een sterker model te geven, dus grote taken en Opus komen samen voor. Het aantal beurten bepaalt de tokens, en in deze plannen volgt het aantal beurten hoeveel werk één dispatch meekreeg.
Wat ik hiervan geleerd heb
- Knip plannen op in taken die een subagent in een paar dozijn beurten afrondt. In mijn data maakt de verse subagent daar zijn belofte waar: een mediaan van 0,8 miljoen tokens per dispatch. Een dispatch met "Tasks 7-9" en "Tasks 10-12" erin is een sessie in vermomming.
- Bundel alleen de kleine klusjes. De skill zegt dat je meerdere kleine, gelijksoortige wijzigingen naar één subagent stuurt in plaats van elke wijziging een eigen subagent te geven, en dat klopt: een dispatch kost de controller zo'n zes beurten van elk een paar honderdduizend tokens, meer dan een kleine taak op zichzelf kost. Bij echte taken werkt het andersom.
- Stop de sessie als het plan klaar is. De laatste review is een goed moment om op te houden. Alles wat je daarna begint, erft bij elke beurt de complete context van de controller.
- Begin het plan in een verse sessie, en start de controller opnieuw als zijn context groot wordt. Een nieuwe sessie die de skill op hetzelfde plan aanroept, gaat verder bij de eerste taak die in de ledger nog geen afrondingsregel heeft. Dat is goedkoper dan een half miljoen tokens meeslepen in elke beurt, en het is dezelfde redenering als weten wanneer je
/cleargebruikt.
Het is hetzelfde patroon dat ik vond toen ik deze transcripts klokte: het dure deel is zelden wat het model zichtbaar aan het doen is.
Dus stel ik mijn eigen regel uit mei bij. Plannen is goedkoop, en uitvoeren bleek ook goedkoop. Wat tokens kost, is lezen, en een verse context blijft alleen vers zolang je de klus klein houdt.