In februari gaf ik mijn woordspel de naam Glyphfall. Sindsdien kom ik steeds andere Glyphfalls tegen: een arena shooter, een ARPG in de terminal, een roguelike deckbuilder, een dungeon crawler voor Android. Voor 2026 had GitHub geen enkele repository met die naam, nu zijn het er vijftien. Ik sprak twee van de makers, en allebei vertelden ze dat de naam van een AI kwam.
Eén naam is een anekdote. De vraag erachter is groter: als je een model om een naam vraagt, hoeveel anderen kregen dan hetzelfde antwoord?
Dus heb ik het gemeten, voor tien soorten projecten.
Hoe ik het gemeten heb
De opzet is die van het experiment met coding agents van een maand geleden: dezelfde opdracht aan veel modellen, elke run in een nieuwe, lege map, elke client vanuit een schone home-map met alleen de login erin. Geen regels, geen geheugen, geen MCP-servers.
Tien opdrachten van elk twee zinnen. Vier zijn games: vallende letters waar je woorden uit veegt, een typgame waarin woorden naar beneden vallen, een roguelike in ASCII in de terminal, en ter controle "an indie game" zonder enig detail. De andere zes zijn dingen waar mensen een model ook vaak een naam voor vragen: een facturatie-SaaS voor freelancers, een CLI-tool die logbestanden in de gaten houdt, een startup die AI-supportagents bouwt, een TypeScript-library voor formuliervalidatie, de heldin van een fantasyroman en een podcast over software engineering. Op kleine verschillen in de formulering na eindigen ze allemaal hetzelfde:
Suggest 10 names for it. Answer with just the names, one per line, best first.
Do not look anything up.Negen modellen beantwoordden alle tien opdrachten vijf keer: Opus, Sonnet en Haiku 5.5 in Claude Code, GPT-5.6 Sol, Terra en Luna, GPT-6 Astra en GPT-6.1 Sol in Codex, en Gemini 3.8 Flash in Antigravity. Die kern telt 450 runs, en alle cijfers hieronder komen daaruit, tenzij ik iets anders zeg. Tien gratis modellen in OpenCode en Freebuff beantwoordden de vier game-opdrachten, met een of twee runs per model. Samen 505 runs van 19 modellen, allemaal op 1 november 2026.
450 namen, veel minder verschillende
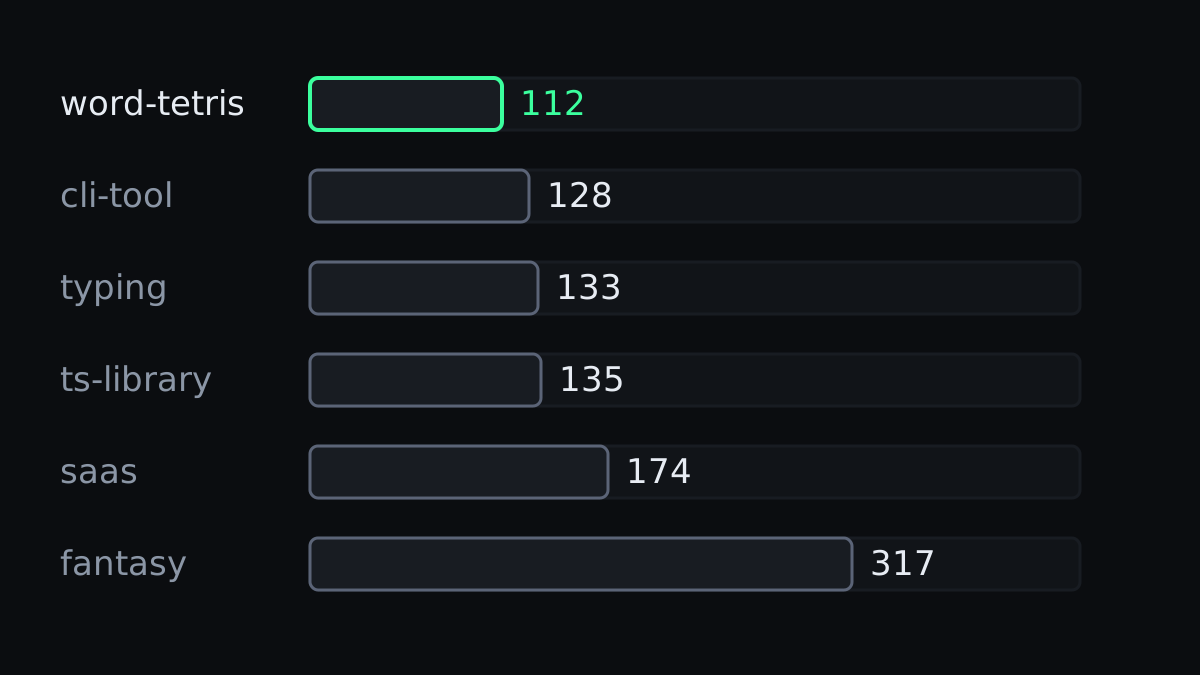
Tien namen per run, vijf runs, negen modellen: 450 namen per opdracht. Bij de CLI-tool zitten daar 128 verschillende tussen. Bij het woordspel 112.
| Opdracht | Verschillende namen, van de 450 | Waar alle negen modellen mee kwamen |
|---|---|---|
| Vallende letters | 112 | Wordfall, Letterfall, StackSpell |
| CLI voor logs | 128 | Spikewatch |
| Typgame | 133 | Wordfall, Typefall |
| Validatie-library | 135 | formcheck |
| Facturatie-SaaS | 174 | Ledgerly |
| Podcast | 201 | geen, Merge Conflict kwam 9 keer als eerste |
| AI-supportstartup | 267 | geen |
| Indiegame | 285 | geen, Lanternfall kwam 10 keer als eerste |
| Roguelike in ASCII | 300 | geen |
| Fantasyheldin | 317 | geen |
Drie leveranciers, negen modellen, en bij de helft van de opdrachten is er een naam waar ze allemaal mee komen. Spikewatch stond in 31 van de 45 runs voor de logbewaker. Over alle 19 modellen genomen was Wordfall in 33 van de 59 runs de eerste suggestie voor het woordspel.
Hoe concreter de opdracht, hoe smaller de antwoorden. Een woordspel, een logbewaker en een validatie-library beschrijven elk één mechanisme, en de namen komen daar allemaal op uit. Een fantasyheldin of "an indie game" laat meer ruimte, dus daar waaieren de lijsten uit.
Ook in die bredere lijsten zitten favorieten. De fantasyheldin heeft 317 verschillende volledige namen, maar Isolde staat in 35 van de 45 runs en Elara in 17, bij zeven van de negen modellen. De indiegame heeft helemaal geen detail, en toch was Hollowlight over alle 19 modellen genomen 13 keer de eerste keus.
De naam komt uit je opdracht
Waar komen die gedeelde namen vandaan? Vooral uit de zelfstandige naamwoorden in de opdracht. Facturen leveren Ledgerly, logs en pieken leveren Spikewatch, formuliervalidatie levert formcheck. Het model pakt het meest veelzeggende woord uit je beschrijving en plakt er een achtervoegsel aan dat naar product klinkt.
De roguelike laat zien hoe sterk die aantrekkingskracht is. In 57 van de 59 runs stond er een naam met glyph erin op de lijst: Glyphgrave, Glyphbound, Glyphdeep, Glyphcrawl. "ASCII" trekt het model naar glyph, en van glyph naar Glyphfall is maar een kleine stap. Die naam kwam voor in 13 roguelike-runs van 9 modellen, en in 11 daarvan was het de eerste keus. Acht van die dertien runs komen van de gratis modellen, die minder runs kregen, maar ook Gemini, Sonnet en GPT-5.6 Sol kwamen ermee.
Dat verklaart de Glyphfalls waarin niets valt. Niemand hoefde iemand na te doen. Een ARPG in de terminal en een dungeon crawler krijgen dezelfde naam omdat hun opdrachten hetzelfde veelzeggende woord bevatten.
Nieuw is nog niet origineel
Glyphfall bestond voor 2026 niet, dus in zekere zin hebben de modellen het verzonnen. Alleen zit er niets nieuws in.
Glyph is een ander woord voor een letter of teken, en zo gebruik ik het in mijn spel. Bij de roguelike pakt het model het zodra het "ASCII" leest. Fall komt uit een genre vol vallende dingen, en de koppeling is precies het soort samenstelling waar de trainingsdata vol mee staat: Wordfall, Letterfall, Starfall.
Een model kiest steeds het waarschijnlijkste volgende stuk. Het kijkt daarbij niet of iemand de naam sinds zijn trainingsdatum al in gebruik heeft genomen, of dat er al een .com voor bestaat. En de waarschijnlijkste combinatie van twee waarschijnlijke stukken is voor iedereen die het vraagt dezelfde.
Dat is de papegaai uit april, maar dan aan het werk met een naam. Hij kan een woord maken dat nog nooit iemand opschreef, en toch is dat woord het waarschijnlijkste. Vraag om tien namen en je krijgt de tien waarschijnlijkste, in ongeveer dezelfde volgorde als iedereen.
Het samplen brengt wat toeval in, en daarom noemt Opus niet elke keer dezelfde naam als eerste. Dat toeval blijft wel dicht bij de top van de lijst. Een originele naam zou betekenen dat je bewust de onwaarschijnlijke keus maakt, en een model dat uit een kansverdeling trekt, is juist gebouwd om dat te vermijden.
De favorieten zijn vaak al bezet
De namen waar de modellen het over eens zijn, bestaan meestal al. formcheck, de packagenaam waar alle negen mee kwamen voor de validatie-library, staat sinds 2018 op npm. Merge Conflict is sinds 2016 een developmentpodcast, en Ship It, door vijf modellen voorgesteld, was een show van Changelog.
Het model biedt ze aan als nieuwe ideeën. In mijn runs mocht het niets opzoeken, en in een chat vraag je het daar meestal ook niet om.
Hoe die namen zich verspreiden
Voor een paar namen uit het experiment telde ik de repository's op GitHub per jaar van aanmaak:
| Naam | Voor 2023 | 2023 tot en met 2024 | 2025 | 2026 tot nu |
|---|---|---|---|---|
| Glyphfall | 0 | 0 | 0 | 15 |
| Hollowlight | 0 | 1 | 1 | 13 |
| Emberwake | 0 | 0 | 4 | 42 |
| Ledgerly | 2 | 10 | 148 | 803 |
Ik kan niet bewijzen dat al die 803 Ledgerly-repository's hun naam van een model hebben. Maar alle negen modellen stellen hem voor als naam voor een facturatie-app, en hij ging van 10 repository's in 2023 en 2024 samen naar 803 dit jaar.
De voor de hand liggende namen gedragen zich anders. Wordfall heeft 101 repository's, waarvan 67 van voor 2026, en Letterfall 38, waarvan 25 ouder. Die namen geven mensen al jaren aan games met vallende letters. De verzonnen namen, zoals Glyphfall, Emberwake en Hollowlight, bestonden nauwelijks tot de modellen ze gingen uitdelen.
Elk model heeft ook een favoriet
Binnen één model zijn de antwoorden nog smaller. In vijf runs gaf Opus 5.5 gemiddeld twee verschillende eerste keuzes per opdracht, en bij vier van de tien opdrachten noemde hij elke keer hetzelfde als eerste. Haiku varieerde het meest, met 3,7 van de 5. Geen van de negen kwam ook maar in de buurt van vijf verschillende eerste keuzes.
Over alle 19 modellen genomen kozen twee runs van verschillende modellen bij de typgame in een kwart van de gevallen dezelfde eerste naam, bij het woordspel in een derde. Twee runs van hetzelfde model deden dat in de helft tot twee derde van de gevallen. De modellen delen dus een voorraad kandidaten, en elk model heeft daarin zijn eigen favoriet, net als het handschrift dat elke modellijn in code liet zien.
Wat dit niet laat zien
- Dat de makers achter die repository's AI gebruikten. Twee makers van een Glyphfall vertelden het me. Op één pagina op itch.io staat dat er geen generatieve AI is gebruikt. Van de rest weet ik het niet.
- Hoe een chat zich gedraagt. Ik gebruikte de coding-clients, zonder gesprek of geheugen rond de prompt. Een chat die meer van je weet, geeft misschien meer variatie, of komt op dezelfde namen uit.
- Of de namen goed zijn. Ik telde hoe vaak modellen dezelfde naam geven, niet of die naam deugt. Wordfall is een prima naam voor een game waarin woorden vallen. Het enige probleem is dat iedereen hem krijgt.
- Gelijk gewicht per model. De negen modellen in de kern hebben vijf runs per opdracht. De gratis modellen in OpenCode en Freebuff hebben er minder, en alleen voor de game-opdrachten.
Wat je met een naam van AI doet
Ga ervan uit dat de eerste suggestie ook die van iedereen is. Lijkt je opdracht op die van een ander, dan is de kans redelijk dat die deze maand dezelfde lijst kreeg. Bovenaan de lijst zitten de botsingen.
Zoek het op voordat je eraan gehecht raakt. GitHub, npm of je eigen package registry, itch.io en de app stores, en het domein. Vijf minuten werk. Het model doet het niet voor je, en juist de namen waarover de modellen het meest eens zijn, zijn het vaakst al bezet.
Kijk of een model jouw naam zelf ook bedenkt. Een woord dat voor jou bijzonder voelt, kan voor een model voor de hand liggen. Ik koos glyph als ander woord voor letters, en toch kwamen 7 modellen met Glyphfall zodra ik mijn spel in twee zinnen beschreef. Leg je opdracht dus aan een paar modellen voor voordat je de naam vastlegt: staat jouw naam in hun lijst, dan staat hij ook in die van de volgende.
Wat het over mij zegt dat ik dezelfde keus maakte als zeven taalmodellen, laat ik maar in het midden. Misschien moet ik me voortaan TimGPT noemen.
Een naam van een model is het standaardantwoord op jouw opdracht. Soms past dat antwoord: in mijn spel vallen echt letters. Voor een roguelike waarin niets valt, is Glyphfall gewoon wat een model zegt zodra je ASCII noemt, en de volgende die ASCII noemt, krijgt hem ook.